Σε αυτό το κεφάλαιο, εξετάζουμε προχωρημένα θέματα της γραμμικής παλινδρόμησης που πηγαίνουν πέρα από τη μοντελοποίηση μιας μεταβλητής απόκρισης με απλές προβλεπτικές μεταβλητές. Δείχνουμε πώς εφαρμόζουμε μετασχηματισμούς, όπως λογαρίθμους και τετραγωνικούς όρους, και εξετάζουμε την επίδρασή τους στην ερμηνεία και στη συμπερασματολογία. Παρουσιάζουμε επίσης τις ψευδομεταβλητές (dummy variables) για την αποτύπωση διαφορών μεταξύ ομάδων και δείχνουμε πώς οι όροι αλληλεπίδρασης επιτρέπουν επιδράσεις που διαφέρουν από ομάδα σε ομάδα.
Η έμφαση δεν δίνεται μόνο στην κατασκευή πιο ευέλικτων μοντέλων, αλλά και στην ερμηνεία τους, ιδιαίτερα καθώς η πολυπλοκότητα αυξάνεται με τους μετασχηματισμούς και τις αλληλεπιδράσεις. Δίνουμε έμφαση στην ανάπτυξη μιας διαισθητικής κατανόησης αυτών των επεκτάσεων και της πρακτικής τους σημασίας. Το κεφάλαιο ολοκληρώνεται με ένα ολοκληρωμένο μοντέλο παλινδρόμησης που συνδυάζει πολλές από αυτές τις τεχνικές σε ένα ενιαίο παράδειγμα.
Η απλούστερη μορφή παλινδρόμησης
Στο Κεφάλαιο Απλή γραμμική παλινδρόμηση, εξετάσαμε τη διμεταβλητή περίπτωση, όπου η εξαρτημένη μεταβλητή παλινδρομείται σε μία μόνο ανεξάρτητη μεταβλητή. Παρόλο που αυτή θεωρείται συχνά η απλούστερη μορφή παλινδρόμησης, το πραγματικά απλούστερο μοντέλο παλινδρόμησης περιλαμβάνει μόνο σταθερό όρο—δηλαδή καμία ανεξάρτητη μεταβλητή.
Ας προετοιμάσουμε το περιβάλλον και ας χρησιμοποιήσουμε τη συνάρτηση lm() της R, για να κάνουμε παλινδρόμηση της μεταβλητής Revenue του συνόλου δεδομένων eshop_revenues μόνο σε έναν σταθερό όρο. Για να ορίσουμε ένα μοντέλο παλινδρόμησης μόνο με σταθερό όρο, γράφουμε τον αριθμό 1 μετά την περισπωμένη (~):
# Βιβλιοθήκεςlibrary(tidyverse)# Εισαγωγή του eshop_revenueseshop_revenues <-read_csv("https://raw.githubusercontent.com/Datakortex/Datasets/refs/heads/main/eshop_revenues.csv")# Προσαρμογή μοντέλου γραμμικής παλινδρόμησηςlm_model <-lm(Revenue ~1,data = eshop_revenues)# Εμφάνιση της σύνοψηςsummary(lm_model)
Call:
lm(formula = Revenue ~ 1, data = eshop_revenues)

Residuals:
   Min     1Q Median     3Q    Max
-15734 -11475  -5294   6267  76867

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept)    16102       1414    11.4   <2e-16 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 16100 on 129 degrees of freedom
Η συνάρτηση summary() εμφανίζει μόνο τον εκτιμημένο σταθερό όρο. Αυτός ο εκτιμημένος σταθερός όρος αντιστοιχεί ακριβώς στο mean της εξαρτημένης μεταβλητής Revenue. Επιπλέον, το standard error του σταθερού όρου είναι ίσο με το standard error του mean του Revenue. Μπορούμε να το επαληθεύσουμε υπολογίζοντας αυτές τις τιμές απευθείας:
# Υπολογισμός του meanmean(eshop_revenues$Revenue)
[1] 16102
# Υπολογισμός του standard errorsd(eshop_revenues$Revenue) /sqrt(nrow(eshop_revenues))
[1] 1414
Αυτοί οι υπολογισμοί δίνουν τις ίδιες τιμές με το αποτέλεσμα της παλινδρόμησης.
Η τιμή t και το p-value στη σύνοψη της παλινδρόμησης αντιστοιχούν σε αυτά ενός t-test ενός δείγματος που συγκρίνει το mean του Revenue με το μηδέν. Με άλλα λόγια, αυτή η παλινδρόμηση μόνο με σταθερό όρο ελέγχει αν το mean της εξαρτημένης μεταβλητής διαφέρει σημαντικά από το μηδέν.
Επειδή αυτό το μοντέλο δεν περιέχει ερμηνευτικές μεταβλητές, δεν εξηγεί καθόλου το variance της εξαρτημένης μεταβλητής. Κατά συνέπεια, ο συντελεστής προσδιορισμού \(R^2\) είναι ακριβώς μηδέν. Επιπλέον, δεν υπολογίζεται στατιστικό F, επειδή το μοντέλο περιλαμβάνει μόνο σταθερό όρο, δηλαδή δεν υπάρχουν προβλεπτικές μεταβλητές για κοινό έλεγχο σημαντικότητας.
Αυτό το απλούστερο μοντέλο παλινδρόμησης λειτουργεί ουσιαστικά ως μοντέλο βάσης ή μηδενικό μοντέλο (baseline ή null model). Αντιπροσωπεύει την αναμενόμενη τιμή της εξαρτημένης μεταβλητής όταν δεν χρησιμοποιείται καμία άλλη πληροφορία για την πρόβλεψη. Πιο σύνθετα μοντέλα με προβλεπτικές μεταβλητές μπορούν να συγκριθούν με αυτό το μοντέλο βάσης, ώστε να αξιολογηθεί η ερμηνευτική τους ικανότητα.
Παλινδρόμηση μέσω της αρχής των αξόνων
Όπως ακριβώς μπορούμε να αφαιρέσουμε την ανεξάρτητη μεταβλητή από ένα μοντέλο απλής γραμμικής παλινδρόμησης, μπορούμε επίσης να αφαιρέσουμε τον σταθερό όρο και να κρατήσουμε μόνο την ανεξάρτητη μεταβλητή. Θυμηθείτε ότι ο σταθερός όρος αντιπροσωπεύει την αναμενόμενη τιμή της εξαρτημένης μεταβλητής όταν η ανεξάρτητη μεταβλητή είναι ίση με μηδέν. Σε αυτή την περίπτωση, ωστόσο, αφαιρώντας τον σταθερό όρο, αναγκάζουμε την ευθεία παλινδρόμησης να περνά από την αρχή των αξόνων, που σημαίνει ότι όταν η τιμή της ανεξάρτητης μεταβλητής είναι μηδέν, η προβλεπόμενη τιμή της εξαρτημένης μεταβλητής είναι επίσης μηδέν.
Κατά συνέπεια, ο συντελεστής κλίσης θα προσαρμοστεί για να αντισταθμίσει την απουσία του σταθερού όρου. Αυτή η αλλαγή μπορεί να μεταβάλει σημαντικά την εκτιμημένη σχέση μεταξύ των μεταβλητών, αυξάνοντας ή μειώνοντας συχνά την κλίση ανάλογα με την κατανομή των δεδομένων.
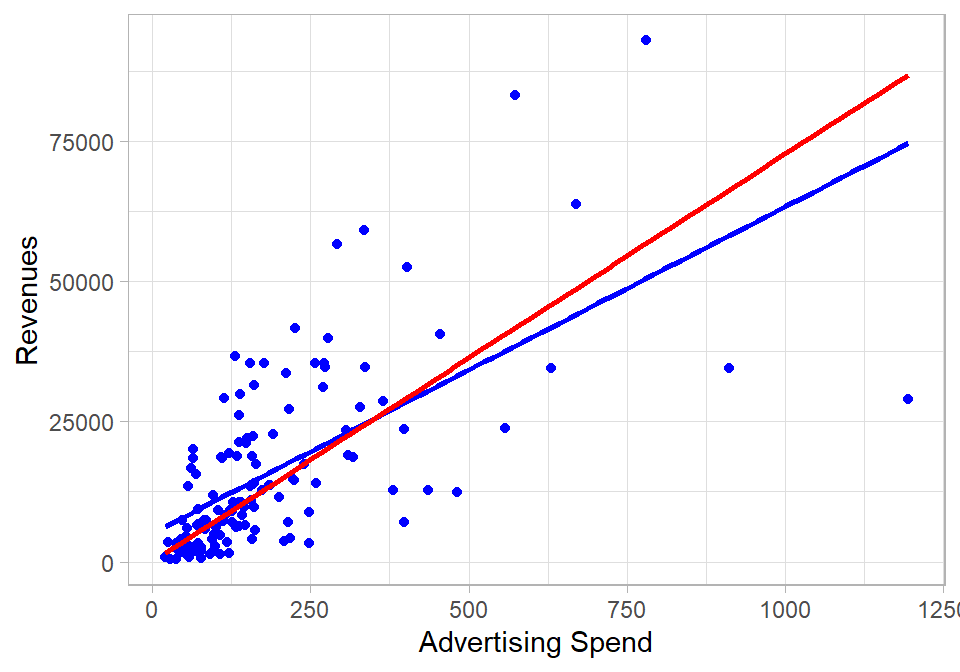
Το παρακάτω διάγραμμα δείχνει τις ευθείες παλινδρόμησης του Revenue στο Ad_Spend, με την τυπική ευθεία παλινδρόμησης με σταθερό όρο σε μπλε χρώμα και την παλινδρόμηση μέσω της αρχής των αξόνων σε κόκκινο:
Εικόνα 26.1: Σύγκριση ευθειών γραμμικής παλινδρόμησης με και χωρίς σταθερό όρο.
Από το διάγραμμα είναι φανερό ότι η κλίση—δηλαδή πόσο απότομη είναι η ευθεία—αλλάζει όταν αναγκάζουμε την ευθεία παλινδρόμησης να περνά από την αρχή των αξόνων \((0, 0)\).
Για να εκτελέσουμε μια παλινδρόμηση μέσω της αρχής των αξόνων στην R, απλώς γράφουμε 0 μετά την περισπωμένη στον τύπο του μοντέλου:
# Προσαρμογή μοντέλου γραμμικής παλινδρόμησηςlm_model <-lm(Revenue ~0+ Ad_Spend,data = eshop_revenues)# Εμφάνιση των συντελεστώνsummary(lm_model)
Call:
lm(formula = Revenue ~ 0 + Ad_Spend, data = eshop_revenues)

Residuals:
   Min     1Q Median     3Q    Max
-57774  -3136    165   9979  41437

Coefficients:
         Estimate Std. Error t value Pr(>|t|)
Ad_Spend     72.7        4.4    16.5   <2e-16 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 12900 on 129 degrees of freedom
Multiple R-squared:  0.679, Adjusted R-squared:  0.676
F-statistic:  273 on 1 and 129 DF,  p-value: <2e-16
Αν και αυτή η προσέγγιση μπορεί να είναι λογική σε ορισμένες περιπτώσεις, για παράδειγμα όταν η εξαρτημένη μεταβλητή δεν μπορεί λογικά να πάρει αρνητικές τιμές και ένας αρνητικός σταθερός όρος δεν θα είχε νόημα, πρέπει να είμαστε προσεκτικοί. Αν ο πραγματικός σταθερός όρος δεν είναι μηδέν, η παράλειψή του οδηγεί σε μεροληπτικές εκτιμήσεις των συντελεστών, επειδή το μοντέλο είναι υποχρεωμένο να περνά από την αρχή των αξόνων ανεξάρτητα από την πραγματική σχέση στα δεδομένα (Wooldridge, 2020).
Επιπλέον, ο συντελεστής προσδιορισμού \(R^2\) μπορεί να είναι παραπλανητικά υψηλός στις παλινδρομήσεις μέσω της αρχής των αξόνων. Αυτό συμβαίνει επειδή ο συνήθης ορισμός του \(R^2\) προϋποθέτει μοντέλο με σταθερό όρο, και η αφαίρεσή του αλλάζει τον υπολογισμό του συνολικού αθροίσματος τετραγώνων. Κατά συνέπεια, επηρεάζεται και το adjusted \(R^2\), το οποίο δεν μπορεί να ερμηνευτεί με τον ίδιο τρόπο όπως στα μοντέλα με σταθερό όρο.
Μαθηματικά, το παραδοσιακό \(R^2\) υπολογίζεται ως εξής:
\[R^2 = 1 - \frac{\text{RSS}}{\text{TSS}}\]
όπου \(\text{RSS}\) είναι το άθροισμα τετραγώνων των καταλοίπων και \(\text{TSS}\) είναι το συνολικό άθροισμα τετραγώνων, υπολογισμένο ως προς το mean της εξαρτημένης μεταβλητής. Ωστόσο, στην παλινδρόμηση μέσω της αρχής των αξόνων, αφού ο σταθερός όρος είναι μηδέν, το \(\text{TSS}\) υπολογίζεται ως προς το μηδέν αντί για το mean, κάτι που γενικά «φουσκώνει» την τιμή του \(R^2\). Επομένως, το \(R^2\) σε αυτή την περίπτωση δεν αντιπροσωπεύει με τον ίδιο τρόπο το ποσοστό του ερμηνευόμενου variance και πρέπει να ερμηνεύεται με προσοχή. Αν υπολογίζαμε το \(R^2\) με το συνηθισμένο \(\text{TSS}\) (ως προς το mean), θα μπορούσε να είναι ακόμη και αρνητικό. Γι’ αυτό, όταν το \(R^2\) είναι σημαντικό μέτρο και η παλινδρόμηση μέσω της αρχής των αξόνων είναι απαραίτητη, χρησιμοποιούνται συχνά εναλλακτικοί ορισμοί ή προσαρμοσμένες εκδοχές του \(R^2\), ώστε να αποτυπώνεται καλύτερα η προσαρμογή του μοντέλου.
Παλινδρόμηση με μία ψευδομεταβλητή
Μέχρι αυτό το σημείο, είδαμε πώς εφαρμόζεται η γραμμική παλινδρόμηση όταν οι ανεξάρτητες μεταβλητές είναι συνεχείς. Ωστόσο, είναι επίσης δυνατό—και αρκετά συνηθισμένο στην πράξη—να συμπεριλάβουμε κατηγορικές μεταβλητές (categorical variables) σε ένα μοντέλο γραμμικής παλινδρόμησης. Η απλούστερη περίπτωση είναι όταν μια κατηγορική μεταβλητή έχει μόνο δύο επίπεδα, τα οποία μπορούμε να αναπαραστήσουμε με μια ψευδομεταβλητή (δυαδική μεταβλητή). Η ερμηνεία των συντελεστών σε αυτή την περίπτωση διαφέρει ελαφρώς από αυτή των συνεχών προβλεπτικών μεταβλητών.
Όταν συμπεριλαμβάνουμε μια ψευδομεταβλητή σε ένα μοντέλο παλινδρόμησης, η εξίσωση μπορεί να γραφτεί ως:
\[y = \beta_0 + \gamma_1 x_1 + u\]
όπου το \(x_1\) είναι μια ψευδομεταβλητή που παίρνει την τιμή 1 για τη μία ομάδα και 0 για την άλλη. Ο σταθερός όρος \(\beta_0\) αντιπροσωπεύει το mean της ομάδας αναφοράς (reference group, όπου \(x_1 = 0\)), και ο συντελεστής \(\gamma_1\) αποτυπώνει τη διαφορά των means μεταξύ των δύο ομάδων. Αυτό σημαίνει ότι η προβλεπόμενη τιμή του \(y\) για την ομάδα με κωδικό 1 είναι \(\beta_0 + \gamma_1\), ενώ για την ομάδα με κωδικό 0 είναι απλώς \(\beta_0\). Ουσιαστικά, η παλινδρόμηση με μια ψευδομεταβλητή εκτιμά τα means των ομάδων και τα συγκρίνει απευθείας.
Η παγίδα των ψευδομεταβλητών και οι ομάδες αναφοράς
Θα μπορούσαμε να δημιουργήσουμε μια ξεχωριστή ψευδομεταβλητή για κάθε ομάδα. Σε αυτή την περίπτωση, το μοντέλο μας θα ήταν:
\[y = \beta_0 +\gamma_1 x_1 + \gamma_2 x_2\]
όπου το \(x_1\) παίρνει την τιμή 1 για την πρώτη ομάδα και 0 διαφορετικά, και το \(x_2\) παίρνει την τιμή 1 για τη δεύτερη ομάδα και 0 διαφορετικά. Εκ πρώτης όψεως, αυτός φαίνεται ένας φυσικός τρόπος να συμπεριλάβουμε ρητά όλες τις ομάδες στο μοντέλο. Ωστόσο, αυτή η προσέγγιση οδηγεί σε τέλεια συγγραμμικότητα, μια κατάσταση όπου μια μεταβλητή μπορεί να προβλεφθεί τέλεια από τις άλλες. Σε αυτή την περίπτωση, το άθροισμα των ψευδομεταβλητών \(x_1 + x_2\) είναι πάντα ίσο με 1, δηλαδή ίδιο με μια στήλη από μονάδες—ακριβώς αυτό που αποτυπώνει ο σταθερός όρος \(\beta_0\). Κατά συνέπεια, το μοντέλο δεν μπορεί να εκτιμήσει μονοσήμαντα όλες τις παραμέτρους. Αυτό το πρόβλημα είναι γνωστό ως παγίδα των ψευδομεταβλητών (dummy variable trap). Για να το αποφύγουμε, εξαιρούμε πάντα μία από τις ψευδομεταβλητές—συνήθως αυτή της ομάδας αναφοράς—ώστε η επίδρασή της να απορροφάται από τον σταθερό όρο.
Στο σύνολο δεδομένων μας, η μεταβλητή New_Product είναι μια τέτοια ψευδομεταβλητή, που δείχνει αν το προϊόν είναι νέο ή όχι. Παρόλο που στην R εμφανίζεται ως αριθμητική (αφού παίρνει τις τιμές 0 ή 1), εννοιολογικά είναι κατηγορική μεταβλητή, στην οποία μπορούμε να κάνουμε παλινδρόμηση του Revenue:
# Προσαρμογή μοντέλου γραμμικής παλινδρόμησηςlm_model <-lm(Revenue ~ New_Product,data = eshop_revenues)# Εμφάνιση των συντελεστώνsummary(lm_model)
Call:
lm(formula = Revenue ~ New_Product, data = eshop_revenues)

Residuals:
   Min     1Q Median     3Q    Max
-19259 -11291  -4211   4162  72009

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept)    14768       1583    9.33  4.1e-16 ***
New_Product     6192       3410    1.82    0.072 .
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 16000 on 128 degrees of freedom
Multiple R-squared:  0.0251,    Adjusted R-squared:  0.0175
F-statistic:  3.3 on 1 and 128 DF,  p-value: 0.0718
Ο εκτιμημένος συντελεστής του New_Product είναι 6,192 και είναι στατιστικά σημαντικός σε επίπεδο σημαντικότητας 10%. Αυτό σημαίνει ότι, κατά μέσο όρο, τα νέα προϊόντα σχετίζονται με αύξηση των εσόδων κατά περίπου €6,192 σε σύγκριση με τα μη νέα προϊόντα. Ο σταθερός όρος είναι 14,768, που αντιπροσωπεύει τα αναμενόμενα έσοδα όταν New_Product = 0—δηλαδή όταν το προϊόν δεν είναι νέο.
Τα εκτιμημένα έσοδα για ένα νέο προϊόν είναι επομένως:
Ένα μοντέλο παλινδρόμησης με μία μόνο ψευδομεταβλητή είναι ισοδύναμο με ένα t-test δύο ανεξάρτητων δειγμάτων, με την υπόθεση ίσων variances στις δύο ομάδες. Στο πλαίσιο της γραμμικής παλινδρόμησης, η υπόθεση των ίσων variances αντιστοιχεί στην υπόθεση της ομοσκεδαστικότητας. Επομένως, η τιμή t και το p-value του συντελεστή της ψευδομεταβλητής ταυτίζονται με αυτά που θα παίρναμε από ένα παραδοσιακό t-test δύο δειγμάτων. Μπορούμε μάλιστα να το επιβεβαιώσουμε με τη συνάρτηση t.test():
# Εκτέλεση ενός t-testt.test(Revenue ~ New_Product, data = eshop_revenues, var.equal =TRUE)
    Two Sample t-test

data:  Revenue by New_Product
t = -2, df = 128, p-value = 0.07
alternative hypothesis: true difference in means between group 0 and group 1 is not equal to 0
95 percent confidence interval:
 -12939    556
sample estimates:
mean in group 0 mean in group 1
          14768           20960
Βλέπουμε επίσης ότι μπορούμε να εφαρμόσουμε τη συνάρτηση t.test() με παρόμοιο τρόπο όπως τη συνάρτηση lm(). Η άλλη επιλογή θα ήταν να έχουμε το Revenue σε δύο ξεχωριστά vectors—ένα για τα νέα προϊόντα και ένα για τα μη νέα—και να εφαρμόσουμε τη t.test() όπως εξηγήσαμε στο Κεφάλαιο Στατιστικοί έλεγχοι.
Παλινδρόμηση με πολλές ψευδομεταβλητές
Αντί για δύο ομάδες, μπορεί να έχουμε τρεις ή περισσότερες ομάδες που ορίζονται από μια κατηγορική μεταβλητή. Για παράδειγμα, ας υποθέσουμε ότι θέλουμε να κατατάξουμε τα προϊόντα μας σε κατηγορίες τιμής: χαμηλή, μεσαία, υψηλή και πολύ υψηλή. Για λόγους απλότητας, δημιουργούμε μια νέα μεταβλητή με το όνομα Price_Level, η οποία παίρνει τέσσερις τιμές με βάση την τιμή του προϊόντος:
1 αν η τιμή είναι κάτω από 50
2 αν η τιμή είναι μεγαλύτερη ή ίση με 50 και κάτω από 100
3 αν η τιμή είναι μεγαλύτερη ή ίση με 100 και κάτω από 150
4 αν η τιμή είναι μεγαλύτερη ή ίση με 150
Μπορούμε να δημιουργήσουμε αυτή τη μεταβλητή με τη συνάρτηση case_when() του πακέτου dplyr:
Τώρα έχουμε δύο βασικές επιλογές για να τη συμπεριλάβουμε σε ένα μοντέλο γραμμικής παλινδρόμησης. Η πρώτη επιλογή είναι να χειριστούμε αυτή τη μεταβλητή ως συνεχή και να τη χρησιμοποιήσουμε ως μία αριθμητική προβλεπτική μεταβλητή:
# Προσαρμογή μοντέλου γραμμικής παλινδρόμησης με το Price_Level ως μία μεταβλητήlm(Revenue ~ Price_Level, data = eshop_revenues) %>%summary()
Call:
lm(formula = Revenue ~ Price_Level, data = eshop_revenues)

Residuals:
   Min     1Q Median     3Q    Max
-18957  -9522  -4728   8065  75406

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept)    25163       3241    7.76  2.3e-12 ***
Price_Level    -3800       1232   -3.08   0.0025 **
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 15600 on 128 degrees of freedom
Multiple R-squared:  0.0692,    Adjusted R-squared:  0.0619
F-statistic: 9.52 on 1 and 128 DF,  p-value: 0.00249
Ο εκτιμημένος συντελεστής του Price_Level είναι -3,800 και είναι στατιστικά σημαντικός σε επίπεδο σημαντικότητας 1%. Αυτό υποδηλώνει ότι, κατά μέσο όρο, η μετάβαση από ένα επίπεδο τιμής στο επόμενο (π.χ. από το επίπεδο 1 στο επίπεδο 2) σχετίζεται με μείωση των εσόδων κατά περίπου €3,800. Ωστόσο, αυτή η ερμηνεία προϋποθέτει ότι τα επίπεδα απέχουν εξίσου μεταξύ τους και ότι η σχέση μεταξύ των επιπέδων τιμής και των εσόδων είναι γραμμική. Αυτή μπορεί να μην είναι έγκυρη υπόθεση, ιδιαίτερα αν η επίδραση της τιμής στα έσοδα είναι μη γραμμική ή μεταβάλλεται ακανόνιστα από επίπεδο σε επίπεδο.
Μια πιο ευέλικτη προσέγγιση είναι να χειριστούμε το Price_Level ως factor. Έτσι λέμε στην R να χειριστεί κάθε επίπεδο ως ξεχωριστή κατηγορία και να συμπεριλάβει στο μοντέλο ψευδομεταβλητές (μία για κάθε επίπεδο εκτός από την κατηγορία αναφοράς). Για να το κάνουμε αυτό, μπορούμε είτε να μετατρέψουμε τη μεταβλητή Price_Level σε factor πριν εφαρμόσουμε τη συνάρτηση lm(), είτε να χρησιμοποιήσουμε τη συνάρτηση factor() απευθείας μέσα στη συνάρτηση lm(). Ο παρακάτω κώδικας δείχνει τη δεύτερη επιλογή.
# Προσαρμογή μοντέλου γραμμικής παλινδρόμησης με το Price_Level ως ψευδομεταβλητέςlm(Revenue ~factor(Price_Level), data = eshop_revenues) %>%summary()
Call:
lm(formula = Revenue ~ factor(Price_Level), data = eshop_revenues)

Residuals:
   Min     1Q Median     3Q    Max
-19109  -9703  -4379   7343  71713

Coefficients:
                     Estimate Std. Error t value Pr(>|t|)
(Intercept)             18103       2693    6.72  5.6e-10 ***
factor(Price_Level)2     3153       3530    0.89    0.373
factor(Price_Level)3    -5232       4456   -1.17    0.242
factor(Price_Level)4    -9555       3839   -2.49    0.014 *
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 15500 on 126 degrees of freedom
Multiple R-squared:  0.101, Adjusted R-squared:  0.0793
F-statistic:  4.7 on 3 and 126 DF,  p-value: 0.00379
Αυτή η προσέγγιση με ψευδομεταβλητές επιτρέπει σε κάθε επίπεδο του Price_Level να έχει τη δική του εκτιμημένη επίδραση στα έσοδα. Η R αφαιρεί αυτόματα το πρώτο επίπεδο (εδώ, το επίπεδο 1) και το χρησιμοποιεί ως ομάδα αναφοράς. Οι συντελεστές που εμφανίζονται δείχνουν τότε πόσο υψηλότερα ή χαμηλότερα είναι τα έσοδα σε κάθε επίπεδο τιμής σε σύγκριση με την ομάδα αναφοράς.
Στην πράξη, η κατηγορική προσέγγιση προτιμάται συχνά όταν τα αριθμητικά επίπεδα αντιπροσωπεύουν διακριτές κατηγορίες χωρίς φυσική σειρά ή όταν δεν αναμένεται η επίδραση της μετάβασης από ένα επίπεδο σε άλλο να είναι γραμμική ή ομοιόμορφη.
Όταν έχουμε μια κατηγορική μεταβλητή, μπορούμε μάλιστα να αφαιρέσουμε τον σταθερό όρο για να αλλάξουμε την ερμηνεία των συντελεστών. Για παράδειγμα, αν αφαιρέσουμε τον σταθερό όρο στο προηγούμενο παράδειγμα, παίρνουμε:
# Προσαρμογή μοντέλου γραμμικής παλινδρόμησης με το Price_Level ως ψευδομεταβλητέςlm(Revenue ~0+factor(Price_Level), data = eshop_revenues) %>%summary()
Call:
lm(formula = Revenue ~ 0 + factor(Price_Level), data = eshop_revenues)

Residuals:
   Min     1Q Median     3Q    Max
-19109  -9703  -4379   7343  71713

Coefficients:
                     Estimate Std. Error t value Pr(>|t|)
factor(Price_Level)1    18103       2693    6.72  5.6e-10 ***
factor(Price_Level)2    21256       2281    9.32  5.0e-16 ***
factor(Price_Level)3    12870       3550    3.63  0.00042 ***
factor(Price_Level)4     8547       2735    3.12  0.00221 **
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 15500 on 126 degrees of freedom
Multiple R-squared:  0.551, Adjusted R-squared:  0.537
F-statistic: 38.7 on 4 and 126 DF,  p-value: <2e-16
Οι εκτιμημένοι συντελεστές αντιπροσωπεύουν τώρα τη μέση τιμή κάθε ομάδας. Αυτοί οι συντελεστές παραμένουν αμερόληπτοι, επειδή δεν «αναγκάζουμε» κάποιον ενιαίο σταθερό όρο να είναι μηδέν· αντίθετα, κάθε ομάδα αποκτά ουσιαστικά τον δικό της σταθερό όρο.
Σημειώστε ότι το \(R^2\) και το adjusted \(R^2\) μπορεί να διαφέρουν από το μοντέλο με έναν μόνο σταθερό όρο, επειδή το σημείο αναφοράς για το mean είναι πλέον τα means των επιμέρους ομάδων και όχι το συνολικό mean. Ως αποτέλεσμα, το ποσοστό του variance που εξηγείται υπολογίζεται ως προς αυτούς τους μέσους όρους ανά ομάδα, κάτι που μπορεί να αλλάξει την ερμηνεία της προσαρμογής του μοντέλου.
Η ANOVA ως ειδική περίπτωση της γραμμικής παλινδρόμησης
Ένα μοντέλο γραμμικής παλινδρόμησης με ψευδομεταβλητές είναι μαθηματικά ισοδύναμο με το F-test της ANOVA που συζητήσαμε στο Κεφάλαιο Στατιστικοί έλεγχοι. Στην πραγματικότητα, αν χρησιμοποιήσουμε τις συναρτήσεις aov() ή anova() της R στο ίδιο μοντέλο, θα πάρουμε ακριβώς το ίδιο στατιστικό F και θα καταλήξουμε στα ίδια συμπεράσματα για τις διαφορές μεταξύ των ομάδων. Αυτό ενισχύει την ιδέα ότι η ANOVA είναι απλώς μια ειδική περίπτωση της γραμμικής παλινδρόμησης, όπου οι προβλεπτικές μεταβλητές είναι ψευδομεταβλητές που αντιπροσωπεύουν κάθε ομάδα.
Συντελεστές beta
Στο Κεφάλαιο Απλή γραμμική παλινδρόμηση, συζητήσαμε πώς οι μονάδες μέτρησης επηρεάζουν την ερμηνεία των συντελεστών—η αλλαγή της κλίμακας μιας μεταβλητής αλλάζει το μέγεθος του συντελεστή, όχι όμως την υποκείμενη σχέση της με την εξαρτημένη μεταβλητή. Ωστόσο, σε πολλές περιπτώσεις δεν μας ενδιαφέρουν καθόλου οι αρχικές μονάδες των μεταβλητών. Αντίθετα, μας ενδιαφέρει να συγκρίνουμε τη σχετική ισχύ των σχέσεων μεταξύ των μεταβλητών, κάτι που απαιτεί κοινή κλίμακα (Wooldridge, 2020).
Για να το πετύχουμε, μπορούμε να κάνουμε standardization στις μεταβλητές μας πριν εφαρμόσουμε τη γραμμική παλινδρόμηση. Το standardization μετασχηματίζει κάθε μεταβλητή ώστε να έχει mean 0 και standard deviation 1. Όταν κάνουμε παλινδρόμηση σε τυποποιημένες μεταβλητές, οι συντελεστές που προκύπτουν ονομάζονται συντελεστές beta (beta coefficients) ή τυποποιημένοι συντελεστές (standardized coefficients). Αυτοί οι συντελεστές δεν έχουν μονάδες και δείχνουν κατά πόσα standard deviations αναμένεται να μεταβληθεί, κατά μέσο όρο, η εξαρτημένη μεταβλητή για αύξηση της ανεξάρτητης μεταβλητής κατά ένα standard deviation.
Επειδή έχει γίνει standardization σε όλες τις μεταβλητές, το mean κάθε μεταβλητής είναι 0. Κατά συνέπεια, ο σταθερός όρος σε αυτή την παλινδρόμηση θα είναι επίσης 0—αντιπροσωπεύει την προβλεπόμενη τιμή της τυποποιημένης εξαρτημένης μεταβλητής όταν όλες οι τυποποιημένες προβλεπτικές μεταβλητές είναι 0, που αντιστοιχεί στη μέση περίπτωση. Για να το δούμε στην πράξη, ας κάνουμε standardization στο Revenue και στο Ad_Spend και στη συνέχεια παλινδρόμηση του τυποποιημένου Revenue στο τυποποιημένο Ad_Spend:
# Τυποποίηση των μεταβλητών Revenue και Ad_Spenddat_standardize <- eshop_revenues %>%mutate(Revenue = (Revenue -mean(Revenue)) /sd(Revenue),Ad_Spend = (Ad_Spend -mean(Ad_Spend)) /sd(Ad_Spend))# Προσαρμογή του μοντέλου γραμμικής παλινδρόμησηςlm_model <-lm(Revenue ~ Ad_Spend,data = dat_standardize)# Εμφάνιση των αποτελεσμάτωνsummary(lm_model)
Call:
lm(formula = Revenue ~ Ad_Spend, data = dat_standardize)

Residuals:
   Min     1Q Median     3Q    Max
-2.823 -0.408 -0.200  0.428  2.769

Coefficients:
             Estimate Std. Error t value Pr(>|t|)
(Intercept) -2.47e-17   6.80e-02     0.0        1
Ad_Spend     6.35e-01   6.83e-02     9.3    5e-16 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 0.776 on 128 degrees of freedom
Multiple R-squared:  0.403, Adjusted R-squared:  0.398
F-statistic: 86.4 on 1 and 128 DF,  p-value: 5.01e-16
Στην απλή διμεταβλητή περίπτωση, προκύπτει μια ενδιαφέρουσα ιδιότητα: ο εκτιμημένος συντελεστής της τυποποιημένης ανεξάρτητης μεταβλητής είναι ίσος με τον συντελεστή συσχέτισης Pearson μεταξύ των δύο μεταβλητών. Αυτό μπορεί να επαληθευτεί με τον παρακάτω κώδικα:
# Υπολογισμός του συντελεστή συσχέτισης Pearsoncor(eshop_revenues$Ad_Spend, eshop_revenues$Revenue)
[1] 0.635
Αυτή η σχέση ισχύει επειδή το standardization αφαιρεί τις μονάδες και κεντράρει τα δεδομένα, κάνοντας την κλίση ισοδύναμη με το μέτρο της γραμμικής συνάφειας μεταξύ των δύο μεταβλητών.
Εφαρμογή λογαριθμικού μετασχηματισμού
Οι συντελεστές beta είναι μια μορφή μετασχηματισμού που κάνει standardization στις μεταβλητές πριν από την προσαρμογή ενός μοντέλου γραμμικής παλινδρόμησης. Αυτός ο μετασχηματισμός επηρεάζει μόνο την κλίμακα των εκτιμημένων συντελεστών, αλλά δεν αλλάζει τη συναρτησιακή μορφή της σχέσης μεταξύ της εξαρτημένης και των ανεξάρτητων μεταβλητών. Αντίθετα, ένας λογαριθμικός μετασχηματισμός (logarithmic transformation) αλλάζει τη μορφή της σχέσης, μεταβάλλοντας την κατανομή των μεταβλητών που εμπλέκονται. Αυτό σημαίνει ότι η παλινδρόμηση μοντελοποιεί πλέον ένα διαφορετικό είδος συνάφειας, που λειτουργεί σε λογαριθμική κλίμακα.
Ο λογαριθμικός μετασχηματισμός είναι ιδιαίτερα χρήσιμος όταν οι μεταβλητές έχουν δεξιά ασύμμετρες κατανομές ή μη γραμμικές σχέσεις. Εφαρμόζοντας τη λογαριθμική συνάρτηση, μπορούμε συχνά να κάνουμε τα μοτίβα να φαίνονται πιο γραμμικά, να μειώσουμε την ετεροσκεδαστικότητα και να φέρουμε τις μεταβλητές πιο κοντά στην κανονικότητα, ικανοποιώντας έτσι καλύτερα τις υποθέσεις της γραμμικής παλινδρόμησης. Σε πολλές περιπτώσεις, πραγματικά δεδομένα όπως το εισόδημα, οι πωλήσεις ή οι διαφημιστικές δαπάνες τείνουν να ακολουθούν λογαριθμοκανονική κατανομή (log-normal), κάτι που κάνει τον λογαριθμικό μετασχηματισμό μια φυσική και εύκολα ερμηνεύσιμη επιλογή (βλ. Κεφάλαιο Λογαριθμοκανονική κατανομή).
Ένα ακόμη κίνητρο για την εφαρμογή λογαριθμικού μετασχηματισμού είναι η ερμηνευσιμότητα. Σε ορισμένους τομείς, ιδιαίτερα στα οικονομικά, στη χρηματοοικονομική και στο μάρκετινγκ, μπορεί να μη μας ενδιαφέρουν οι απόλυτες μεταβολές του αποτελέσματος, αλλά οι ποσοστιαίες ή αναλογικές μεταβολές. Για παράδειγμα, αντί να πούμε ότι «επιπλέον €1,000 σε διαφημιστική δαπάνη αυξάνουν τα έσοδα κατά €500», μπορεί να μας ενδιαφέρει περισσότερο να πούμε ότι «αύξηση 1% στη διαφημιστική δαπάνη οδηγεί σε αύξηση 0.5% στα έσοδα». Αυτή η ερμηνεία προκύπτει φυσικά στα μοντέλα log-log, όπου τόσο η εξαρτημένη όσο και η ανεξάρτητη μεταβλητή μετασχηματίζονται με τον φυσικό λογάριθμο.
Ερμηνεία συντελεστών log-linear για μεγάλες μεταβολές
Η ποσοστιαία ερμηνεία είναι ακριβής μόνο για μικρές μεταβολές. Για μεγαλύτερες μεταβολές, η γραμμική προσέγγιση γίνεται λιγότερο αξιόπιστη και είναι προτιμότερο να χρησιμοποιήσουμε την πραγματική εξίσωση:
Έτσι παίρνουμε μια πιο ακριβή εκτίμηση της επίδρασης σε μεγαλύτερα διαστήματα.
Ο λογαριθμικός μετασχηματισμός δεν χρειάζεται να εφαρμοστεί και στις δύο μεταβλητές. Μπορούμε να τον εφαρμόσουμε στην εξαρτημένη μεταβλητή, σε μια ανεξάρτητη μεταβλητή ή και στις δύο. Επιπλέον, μπορούμε να μετασχηματίσουμε πολλές ανεξάρτητες μεταβλητές στο ίδιο μοντέλο. Κάθε επιλογή οδηγεί σε διαφορετικό τύπο μοντέλου, όπως συνοψίζεται στον παρακάτω πίνακα:
Τύπος στην lm()
Τύπος μοντέλου
Ερμηνεία
y ~ x
Linear-Linear
Αύξηση του x κατά 1 μονάδα σχετίζεται με μεταβολή του y κατά β μονάδες
y ~ log(x)
Linear-Log
Αύξηση του x κατά 1% σχετίζεται με μεταβολή του y κατά β / 100 μονάδες
log(y) ~ x
Log-Linear
Αύξηση του x κατά 1 μονάδα σχετίζεται με μεταβολή του y κατά 100 × β %
log(y) ~ log(x)
Log-Log
Αύξηση του x κατά 1% σχετίζεται με μεταβολή του y κατά β %
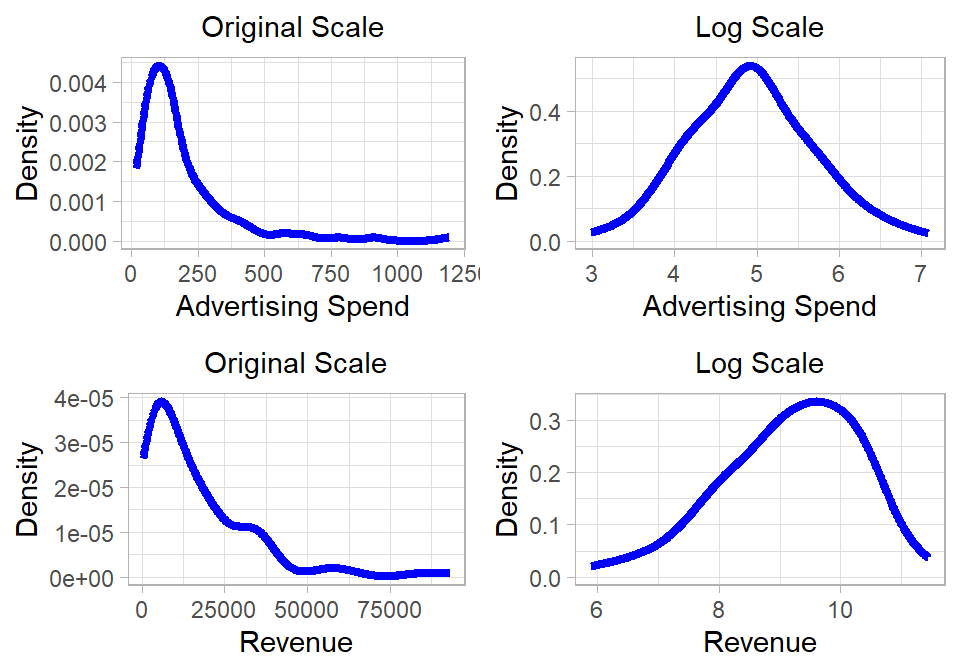
Στο σύνολο δεδομένων μας, τόσο η εξαρτημένη μεταβλητή Revenue όσο και η ανεξάρτητη μεταβλητή Ad_Spend έχουν δεξιά ασύμμετρες κατανομές. Αυτές είναι χαρακτηριστικές των λογαριθμοκανονικών κατανομών, κάτι που υποδηλώνει ότι ένας λογαριθμικός μετασχηματισμός μπορεί να κάνει τις μεταβλητές πιο συμμετρικές και πιο κατάλληλες για γραμμική μοντελοποίηση. Τα παρακάτω διαγράμματα δείχνουν την κατανομή των μεταβλητών Ad_Spend και Revenue πριν και μετά τον λογαριθμικό μετασχηματισμό:
Εικόνα 26.2: Κατανομή των εσόδων και της διαφημιστικής δαπάνης στην αρχική και στη λογαριθμική κλίμακα.
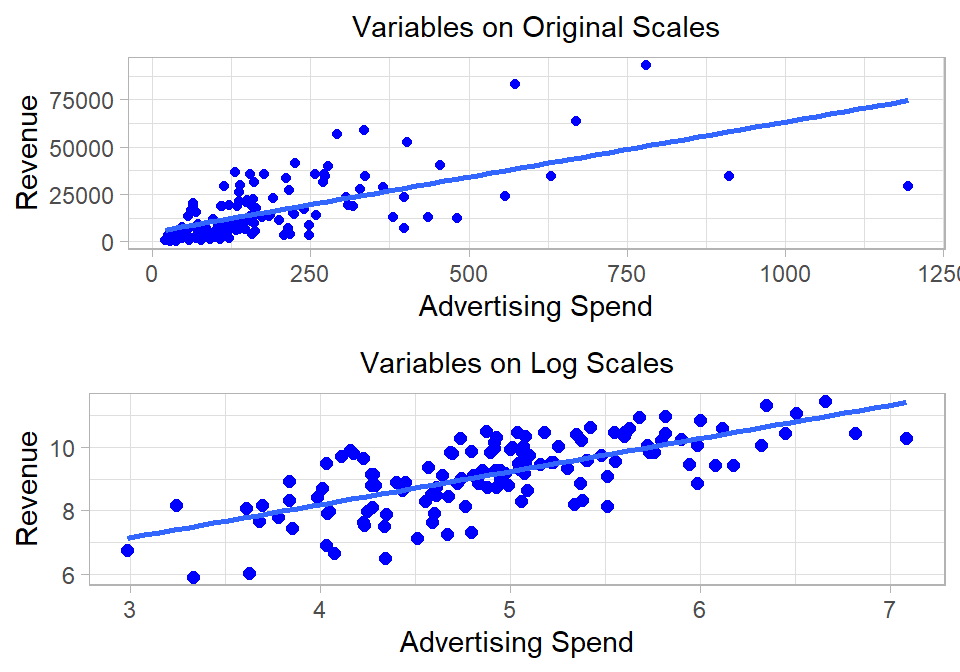
Τα παρακάτω διαγράμματα δείχνουν επίσης πώς ένας λογαριθμικός μετασχηματισμός μπορεί να κάνει πολύ πιο εύκολη την προσαρμογή ενός γραμμικού μοντέλου. Στο επάνω διάγραμμα βλέπουμε τις αρχικές μεταβλητές, οι οποίες παρουσιάζουν μη γραμμική σχέση. Στο κάτω διάγραμμα, αφού πάρουμε τον λογάριθμο και των δύο μεταβλητών, η σχέση φαίνεται πολύ πιο γραμμική και η ευθεία παλινδρόμησης προσαρμόζεται καλύτερα στα δεδομένα. Αυτή η βελτιωμένη γραμμικότητα είναι ένας από τους λόγους για τους οποίους οι λογαριθμικοί μετασχηματισμοί χρησιμοποιούνται συχνά στην πράξη:
Εικόνα 26.3: Γραμμική παλινδρόμηση στην αρχική και στη λογαριθμική κλίμακα.
Παρατηρούμε επίσης ότι ο λογαριθμικός μετασχηματισμός μειώνει την επίδραση των outliers. Οι ακραία μεγάλες τιμές, που μπορούν να επηρεάσουν δυσανάλογα τις εκτιμήσεις της παλινδρόμησης, συμπιέζονται στη λογαριθμική κλίμακα, σταθεροποιώντας έτσι την εκτίμηση και βελτιώνοντας την ανθεκτικότητα του μοντέλου.
Ωστόσο, πρέπει να είμαστε προσεκτικοί όταν εφαρμόζουμε λογαριθμικό μετασχηματισμό. Οι λογάριθμοι ορίζονται μόνο για θετικούς αριθμούς. Αν η μεταβλητή περιέχει μηδενικές ή αρνητικές τιμές, πρέπει είτε να φιλτράρουμε είτε να μετατοπίσουμε κατάλληλα τα δεδομένα (π.χ. με log(x + 1)), είτε να εξετάσουμε έναν εναλλακτικό μετασχηματισμό. Αυθαίρετες προσαρμογές όπως το log(x + 1) πρέπει να τεκμηριώνονται προσεκτικά, καθώς επηρεάζουν την ερμηνεία των συντελεστών.
Ας εφαρμόσουμε τώρα έναν μετασχηματισμό log-log στην R, όπου τόσο η εξαρτημένη όσο και η ανεξάρτητη μεταβλητή λογαριθμίζονται πριν από την προσαρμογή του μοντέλου παλινδρόμησης:
# Προσαρμογή του μοντέλου γραμμικής παλινδρόμησης - log-loglm_model_log_log <-lm(log(Revenue) ~log(Ad_Spend),data = eshop_revenues)# Εμφάνιση των αποτελεσμάτωνsummary(lm_model_log_log)
Call:
lm(formula = log(Revenue) ~ log(Ad_Spend), data = eshop_revenues)

Residuals:
    Min      1Q  Median      3Q     Max
-2.0535 -0.4439  0.0595  0.5966  1.5515

Coefficients:
              Estimate Std. Error t value Pr(>|t|)
(Intercept)     4.0004     0.4602    8.69  1.5e-14 ***
log(Ad_Spend)   1.0470     0.0921   11.37  < 2e-16 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 0.802 on 128 degrees of freedom
Multiple R-squared:  0.502, Adjusted R-squared:  0.498
F-statistic:  129 on 1 and 128 DF,  p-value: <2e-16
Ο εκτιμημένος συντελεστής του log(Ad_Spend) είναι περίπου 1.05 και είναι στατιστικά σημαντικός σε επίπεδο 1%. Αυτό σημαίνει ότι, κατά μέσο όρο, αύξηση 1% στη διαφημιστική δαπάνη σχετίζεται με αύξηση 1.05% στα έσοδα.
Είναι ενδιαφέρον ότι οι τιμές του R-squared και του adjusted R-squared έχουν αυξηθεί σε σχέση με το μη μετασχηματισμένο μοντέλο. Αν και αυτό μπορεί να υποδηλώνει καλύτερη προσαρμογή, πρέπει να είμαστε προσεκτικοί στην ερμηνεία τέτοιων βελτιώσεων ανάμεσα σε μοντέλα με διαφορετικές κλίμακες. Ο λογαριθμικός μετασχηματισμός της εξαρτημένης μεταβλητής συμπιέζει το εύρος των τιμών της, κάνοντας ευκολότερη την εξήγηση της μεταβλητότητας. Επομένως, το R-squared μπορεί να φαίνεται τεχνητά υψηλότερο, ακόμη κι αν η προβλεπτική ικανότητα δεν βελτιώνεται στην αρχική κλίμακα.
Αξίζει επίσης να σημειώσουμε ότι, παρόλο που εφαρμόζουμε γραμμική παλινδρόμηση, ο λογαριθμικός μετασχηματισμός σημαίνει ότι μοντελοποιούμε μια μη γραμμική σχέση στα αρχικά δεδομένα. Αυτό είναι ένα λεπτό αλλά σημαντικό σημείο: το μοντέλο παλινδρόμησης παραμένει γραμμικό ως προς τις παραμέτρους, αλλά μη γραμμικό ως προς τις μεταβλητές.
Στην πράξη, η βάση του λογαρίθμου (φυσικός λογάριθμος, βάση 10, βάση 2 κ.λπ.) δεν επηρεάζει τα ποιοτικά αποτελέσματα της παλινδρόμησης—απλώς αλλάζει την κλίμακα των συντελεστών (και σε ένα μοντέλο log-log, όπου και οι δύο μεταβλητές χρησιμοποιούν την ίδια βάση, η κλίση δεν αλλάζει καθόλου). Τα περισσότερα στατιστικά πακέτα, μεταξύ των οποίων και η R, χρησιμοποιούν από προεπιλογή τον φυσικό λογάριθμο (λογάριθμο με βάση e). Αν χρησιμοποιήσουμε διαφορετική βάση, η ερμηνεία των συντελεστών πρέπει να προσαρμοστεί ανάλογα. Για λόγους συνέπειας και συγκρισιμότητας μεταξύ μελετών, προτιμάται γενικά ο φυσικός λογάριθμος.
Προσθήκη πολυωνυμικών όρων
Μια άλλη επιλογή για να βελτιώσουμε ένα μοντέλο γραμμικής παλινδρόμησης είναι να συμπεριλάβουμε τετραγωνικούς (quadratic) ή πολυωνυμικούς όρους ανώτερης τάξης (higher-order polynomial terms). Ένας τετραγωνικός όρος προκύπτει αν υψώσουμε μια ανεξάρτητη μεταβλητή στο τετράγωνο και συμπεριλάβουμε αυτόν τον όρο ως επιπλέον ανεξάρτητη μεταβλητή στο μοντέλο. Έτσι το μοντέλο μπορεί να αποτυπώσει μη γραμμικές σχέσεις—συγκεκριμένα, σχέσεις που ακολουθούν καμπύλη (παραβολική) μορφή αντί για ευθεία γραμμή.
Η συμπερίληψη ενός τετραγωνικού όρου αλλάζει την ερμηνεία των συντελεστών. Σε ένα μοντέλο της μορφής:
\[y = \beta_0 + \beta_1 x_1 + \beta_2 x^2_1 + u\]
Εδώ, ο συντελεστής \(\beta_1\) αντιπροσωπεύει την οριακή επίδραση της διαφημιστικής δαπάνης όταν το Ad_Spend είναι μηδέν, ενώ ο συντελεστής \(\beta_2\) αποτυπώνει τον ρυθμό με τον οποίο μεταβάλλεται η οριακή επίδραση του Ad_Spend: η οριακή επίδραση είναι \(\beta_1 + 2\beta_2 x_1\), οπότε μεταβάλλεται κατά \(2\beta_2\) για κάθε αύξηση του \(x_1\) κατά μία μονάδα. Συνολικά, το μοντέλο επιτρέπει στη σχέση μεταξύ διαφήμισης και εσόδων να καμπυλώνεται είτε προς τα πάνω είτε προς τα κάτω, ανάλογα με το πρόσημο και το μέγεθος του \(\beta_2\). Αυτή η πρόσθετη ευελιξία μπορεί να βελτιώσει την προσαρμογή του μοντέλου όταν η πραγματική σχέση είναι μη γραμμική.
Στην R, μπορούμε να συμπεριλάβουμε πολυωνυμικούς όρους με τη συνάρτηση I(), η οποία αποτρέπει την ερμηνεία του τελεστή ^ ως τελεστή του τύπου:
# Προσαρμογή του μοντέλου γραμμικής παλινδρόμησης με τετραγωνικό όροlm_model_poly <-lm(Revenue ~ Ad_Spend +I(Ad_Spend^2),data = eshop_revenues)# Εμφάνιση των αποτελεσμάτωνsummary(lm_model_poly)
Call:
lm(formula = Revenue ~ Ad_Spend + I(Ad_Spend^2), data = eshop_revenues)

Residuals:
   Min     1Q Median     3Q    Max
-27627  -5880  -2016   5768  44951

Coefficients:
               Estimate Std. Error t value Pr(>|t|)
(Intercept)   -1.87e+03   2.14e+03   -0.87     0.38
Ad_Spend       1.21e+02   1.48e+01    8.13  3.3e-13 ***
I(Ad_Spend^2) -7.27e-02   1.59e-02   -4.58  1.1e-05 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 11600 on 127 degrees of freedom
Multiple R-squared:  0.488, Adjusted R-squared:  0.48
F-statistic: 60.4 on 2 and 127 DF,  p-value: <2e-16
Το μοντέλο περιλαμβάνει ως προβλεπτικές μεταβλητές τόσο έναν γραμμικό όρο (Ad_Spend) όσο και έναν τετραγωνικό όρο (Ad_Spend^2). Η εκτιμημένη εξίσωση παλινδρόμησης είναι:
Τόσο ο γραμμικός όσο και ο τετραγωνικός όρος είναι στατιστικά σημαντικοί σε επίπεδο 1%, με p-values πολύ μικρότερα από 0.01. Αυτό αποτελεί ισχυρή ένδειξη μη γραμμικής σχέσης μεταξύ διαφημιστικής δαπάνης και εσόδων.
Η ερμηνεία των συντελεστών είναι η εξής:
Ο συντελεστής του Ad_Spend (120.66) δείχνει ότι, σε πολύ χαμηλά επίπεδα δαπάνης, η αύξηση του Ad_Spend σχετίζεται με υψηλότερα έσοδα—περίπου €120.66 για κάθε επιπλέον μονάδα δαπάνης.
Ο αρνητικός συντελεστής του τετραγωνικού όρου (-0.07) αντανακλά φθίνουσες αποδόσεις (diminishing returns): ενώ η διαφήμιση είναι ωφέλιμη στην αρχή, η επίδρασή της μειώνεται όσο αυξάνεται η δαπάνη. Τελικά, το κόστος της επιπλέον διαφήμισης ξεπερνά το όφελος και τα έσοδα αρχίζουν να μειώνονται. Αυτό είναι συνηθισμένο σε επιχειρηματικά περιβάλλοντα όπου εμφανίζεται κορεσμός. Πέρα από ένα σημείο, οι πελάτες έχουν ήδη προσεγγιστεί ή δεν επηρεάζονται περαιτέρω, κάνοντας την επιπλέον διαφημιστική δαπάνη αναποτελεσματική.
Επομένως, μια αύξηση του Ad_Spend κατά 1 μονάδα (ξεκινώντας από το μηδέν) σχετίζεται με αύξηση των εσόδων κατά περίπου 120.66 μονάδες, αλλά αυτή η επίδραση μειώνεται σταδιακά λόγω του αρνητικού τετραγωνικού όρου· σε υψηλότερα επίπεδα του Ad_Spend, τα οφέλη μειώνονται και μπορεί ακόμη και να γίνουν αρνητικά.
Η προσθήκη ενός τετραγωνικού όρου συχνά βελτιώνει την καλή προσαρμογή, όπως μετριέται από τις τιμές του R-squared και του adjusted R-squared. Ωστόσο, πρέπει να είμαστε προσεκτικοί: το ότι ένα μοντέλο προσαρμόζεται καλύτερα αριθμητικά δεν σημαίνει ότι είναι καλύτερο εννοιολογικά ή ουσιαστικά.
Τετραγωνικοί όροι με λογαριθμισμένες μεταβλητές: η σειρά έχει σημασία
Αν δουλεύουμε με λογαριθμισμένες μεταβλητές και θέλουμε να συμπεριλάβουμε τετραγωνικούς όρους, πρέπει να προσέξουμε τη σειρά των πράξεων. Το τετράγωνο της λογαριθμισμένης μεταβλητής log(Ad_Spend) δεν είναι το ίδιο με τον λογάριθμο μιας μεταβλητής υψωμένης στο τετράγωνο. Δηλαδή:
\[[\log(x)]^2 \ne \log(x^2)\]
Με βάση τις ιδιότητες των λογαρίθμων:
\[\log(x^2) = 2 \cdot \log(x)\]
Ενώ:
\[[\log(x)]^2 = \log(x) \cdot \log(x)\]
Αυτή η διάκριση είναι σημαντική όταν κατασκευάζουμε μοντέλα. Αν συμπεριλάβουμε σε μια παλινδρόμηση και το \(\log(x)\) και το \(\log(x^2)\), στην ουσία συμπεριλαμβάνουμε το \(\log(x)\) και το \(2 \cdot \log(x)\), τα οποία είναι προφανώς τέλεια συγγραμμικά. Σε τέτοιες περιπτώσεις, η R αφαιρεί αυτόματα έναν από τους όρους, ώστε να αποφύγει την τέλεια συγγραμμικότητα και να προσαρμόσει σωστά το μοντέλο.
Η εισαγωγή τετραγωνικών (και ανώτερης τάξης) όρων αυξάνει την ευελιξία του μοντέλου, επιτρέποντάς του να αποτυπώνει πιο σύνθετα μοτίβα στα δεδομένα. Μάλιστα, αν συνεχίσουμε να προσθέτουμε πολυωνυμικούς όρους—ας πούμε, έως την 9η δύναμη με 10 σημεία δεδομένων—μπορούμε να κατασκευάσουμε ένα μοντέλο που περνά από κάθε σημείο. Ωστόσο, ένα τέτοιο μοντέλο θα ήταν στις περισσότερες περιπτώσεις χωρίς νόημα όσον αφορά την ερμηνεία και τη στατιστική συμπερασματολογία.
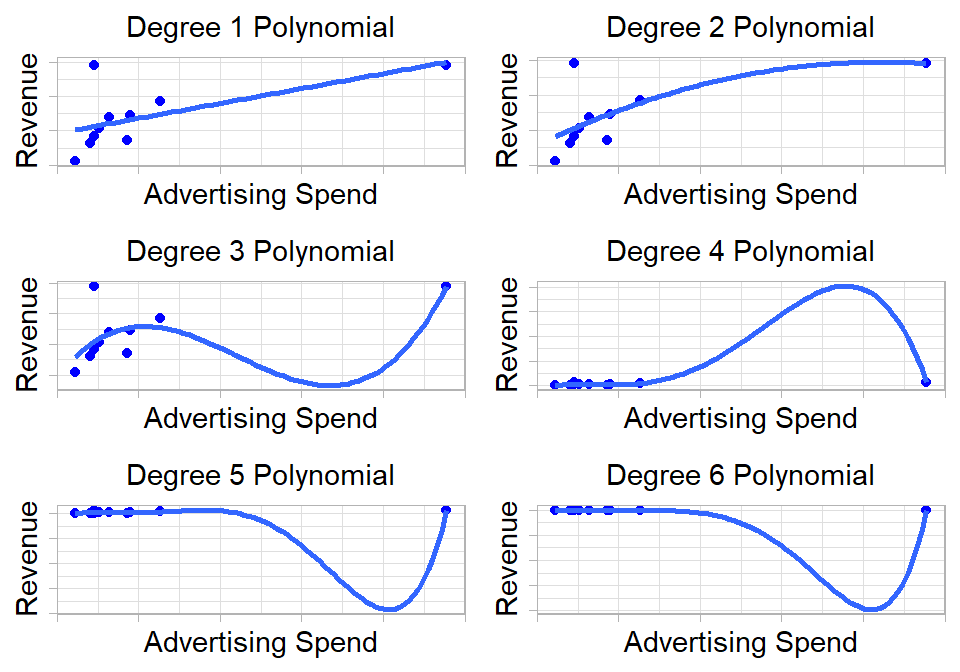
Για να το δείξουμε, ας θεωρήσουμε ένα απλό παράδειγμα με μόνο τις πρώτες 10 παρατηρήσεις του συνόλου δεδομένων μας. Μπορούμε να προσαρμόσουμε διάφορα μοντέλα, ξεκινώντας από ένα μοντέλο απλής γραμμικής παλινδρόμησης και προσθέτοντας πολυωνυμικούς όρους έως τον 6ο βαθμό. Τα παρακάτω διαγράμματα δείχνουν ξεχωριστά τα σημεία δεδομένων και τις καμπύλες παλινδρόμησης:
Εικόνα 26.4: Γραμμική παλινδρόμηση με διαφορετικούς πολυωνυμικούς όρους.
Μετά από ένα σημείο (συχνά μετά τον τετραγωνικό ή τον κυβικό όρο), η προσθήκη περισσότερων δυνάμεων δεν βελτιώνει την κατανόησή μας για τη σχέση. Οι συντελεστές γίνονται πιο δύσκολο να ερμηνευτούν και το μοντέλο γίνεται λιγότερο χρήσιμο για την εξήγηση της σχέσης. Θυμηθείτε ότι ο στόχος μας δεν είναι απλώς να προσαρμόσουμε τα δεδομένα, αλλά να παράγουμε αμερόληπτες, αποτελεσματικές εκτιμήσεις που ερμηνεύονται και υποστηρίζουν τη στατιστική συμπερασματολογία. Αν μας ενδιέφερε μόνο να σχεδιάσουμε μια καμπύλη που περνά από κάθε σημείο, δεν θα χρειαζόταν να ασχοληθούμε με υποθέσεις ή συμπερασματολογία.
Τέλος, είδαμε ότι τα μοντέλα παλινδρόμησης OLS μπορούν να επηρεαστούν από outliers, ιδιαίτερα από παρατηρήσεις με ασυνήθιστες τιμές των ανεξάρτητων μεταβλητών. Ωστόσο, τα πολυωνυμικά μοντέλα—και ιδιαίτερα τα τετραγωνικά—είναι συχνά ακόμη πιο ευαίσθητα. Ο λόγος είναι ότι ο τετραγωνικός όρος μεγεθύνει τις μεγάλες τιμές της ανεξάρτητης μεταβλητής: μια παρατήρηση με μεγάλη τιμή του \(x\) θα έχει ακόμη μεγαλύτερη τιμή του \(x ^ 2\). Κατά συνέπεια, τα outliers μπορούν να ασκήσουν δυσανάλογη επίδραση στην εκτιμημένη καμπύλη παλινδρόμησης, δημιουργώντας ή μεγεθύνοντας φαινομενικές μη γραμμικότητες που δεν αντανακλούν την υποκείμενη σχέση στον πληθυσμό.
Επιδράσεις αλληλεπίδρασης
Μέχρι τώρα υποθέσαμε ότι η επίδραση κάθε ανεξάρτητης μεταβλητής στην εξαρτημένη μεταβλητή είναι προσθετική, δηλαδή ότι κάθε μεταβλητή συμβάλλει στο αποτέλεσμα ανεξάρτητα από τις άλλες. Ωστόσο, αυτό δεν είναι πάντα ρεαλιστικό. Μερικές φορές, η επίδραση μιας μεταβλητής εξαρτάται από το επίπεδο μιας άλλης μεταβλητής. Σε τέτοιες περιπτώσεις, συμπεριλαμβάνουμε στο μοντέλο μας έναν όρο αλληλεπίδρασης (interaction term).
Μια αλληλεπίδραση μας επιτρέπει να μοντελοποιήσουμε τη συνδυασμένη επίδραση δύο μεταβλητών, η οποία πηγαίνει πέρα από το απλό άθροισμα των επιμέρους επιδράσεών τους. Για παράδειγμα, φανταστείτε μια εταιρεία που πουλά δύο τύπους προϊόντων: βασικά και premium. Η επίδραση της εμπειρίας ενός πωλητή στις πωλήσεις μπορεί να διαφέρει ανάλογα με τον τύπο του προϊόντος. Για τα βασικά προϊόντα, ακόμη και ένας νέος πωλητής μπορεί να πουλά καλά, επειδή το προϊόν είναι απλό, ενώ για τα premium προϊόντα μπορεί να χρειάζονται πιο έμπειροι πωλητές για να κλείσουν επιτυχώς τις συμφωνίες. Εδώ, η επίδραση της εμπειρίας στις πωλήσεις εξαρτάται από τον τύπο του προϊόντος—αυτό είναι μια αλληλεπίδραση. Συμπεριλαμβάνοντας στο μοντέλο παλινδρόμησης έναν όρο αλληλεπίδρασης μεταξύ εμπειρίας και τύπου προϊόντος, αποτυπώνουμε αυτή τη λεπτή σχέση που καμία από τις δύο μεταβλητές δεν μπορεί να εξηγήσει μόνη της.
1. Επίδραση αλληλεπίδρασης με ψευδομεταβλητές:
Ας ξεκινήσουμε με την απλούστερη περίπτωση: τις αλληλεπιδράσεις μεταξύ δύο ψευδομεταβλητών. Ένα μοντέλο γραμμικής παλινδρόμησης με δύο ψευδομεταβλητές και την επίδραση αλληλεπίδρασής τους μπορεί να γραφτεί ως:
Οι μεταβλητές \(x_1\) και \(x_2\) είναι δύο ψευδομεταβλητές, ενώ ο όρος \(x_1 \cdot x_2\) είναι ο όρος αλληλεπίδρασης. Η λογική του πολλαπλασιασμού είναι απλή: όταν και οι δύο ψευδομεταβλητές είναι 1, το γινόμενό τους είναι επίσης 1, και ο όρος αλληλεπίδρασης «ενεργοποιείται». Αν οποιαδήποτε από τις δύο μεταβλητές είναι 0, το γινόμενο είναι 0 και ο όρος αλληλεπίδρασης δεν έχει καμία επίδραση.
Ως παράδειγμα, θα χρησιμοποιήσουμε δύο κατηγορικές μεταβλητές: το Price_Level (με τέσσερα επίπεδα) και το New_Product (δυαδικός δείκτης: 1 αν το προϊόν είναι νέο, 0 διαφορετικά). Ο στόχος μας είναι να δούμε αν η επίδραση του Price_Level στα έσοδα διαφέρει ανάλογα με το αν το προϊόν είναι νέο. Για να το μοντελοποιήσουμε, συμπεριλαμβάνουμε και τις δύο μεταβλητές και τον όρο αλληλεπίδρασής τους:
Στην R, συμπεριλαμβάνουμε όρους αλληλεπίδρασης στο μοντέλο είτε με τον αστερίσκο (*) (που περιλαμβάνει τις κύριες επιδράσεις και την αλληλεπίδραση) είτε με την άνω και κάτω τελεία (:) (που περιλαμβάνει μόνο την αλληλεπίδραση):
Στο αποτέλεσμα, βλέπουμε συντελεστές για όλα τα επίπεδα των ψευδομεταβλητών εκτός από τον συνδυασμό αναφοράς—σε αυτή την περίπτωση, Price_Level = 1 και New_Product = 0. Αυτό σημαίνει ότι η ομάδα βάσης είναι τα υπάρχοντα προϊόντα στο επίπεδο τιμής 1. Ο σταθερός όρος αποτυπώνει τα αναμενόμενα έσοδα για αυτή την ομάδα αναφοράς.
Δυαδικές προβλεπτικές μεταβλητές ως factors
Επειδή το New_Product παίρνει μόνο δύο τιμές, δεν έχει καμία διαφορά αν το χρησιμοποιήσουμε ως αριθμητική μεταβλητή ή ως factor στη lm().
Επιπλέον, βλέπουμε τρεις επιδράσεις αλληλεπίδρασης, μία για καθένα από τα τρία επίπεδα του Price_Level που δεν είναι επίπεδα αναφοράς. Αυτοί οι συντελεστές μας λένε πώς μεταβάλλονται τα έσοδα των νέων προϊόντων σε σχέση με τα υπάρχοντα προϊόντα σε κάθε επίπεδο τιμής.
Οι επιδράσεις αλληλεπίδρασης μπορεί μερικές φορές να είναι δύσκολες στην ερμηνεία, αλλά η αντικατάσταση τιμών τις κάνει πιο κατανοητές. Δείτε πώς ερμηνεύεται κάθε συντελεστής:
\(\beta_0 = 19,019\): Αυτά είναι τα αναμενόμενα έσοδα όταν Price_Level = 1 και New_Product = 0 (δηλαδή για ένα υπάρχον προϊόν στο επίπεδο τιμής βάσης). Ο συντελεστής είναι στατιστικά σημαντικός σε επίπεδο 1%, κάτι που δείχνει ότι αυτά τα βασικά έσοδα διαφέρουν αξιόπιστα από το μηδέν.
\(\gamma_1 = -478\): Στα υπάρχοντα προϊόντα, το επίπεδο τιμής 2 σχετίζεται με μείωση των εσόδων κατά περίπου €478 σε σύγκριση με το επίπεδο τιμής 1. Αυτή η επίδραση δεν διαφέρει στατιστικά σημαντικά από το 0 ούτε σε επίπεδο σημαντικότητας 10%, που σημαίνει ότι δεν μπορούμε να συμπεράνουμε με βεβαιότητα ότι το επίπεδο 2 διαφέρει από το επίπεδο 1 για τα υπάρχοντα προϊόντα.
\(\gamma_2 = -8,942\): Στα υπάρχοντα προϊόντα, το επίπεδο τιμής 3 οδηγεί σε μείωση των εσόδων κατά περίπου €8,942 σε σύγκριση με το επίπεδο 1. Αυτή η επίδραση είναι στατιστικά σημαντική σε επίπεδο σημαντικότητας 10%, υποδηλώνοντας μια πιθανή αλλά όχι οριστική διαφορά.
\(\gamma_3 = -10,490\): Στα υπάρχοντα προϊόντα, το επίπεδο τιμής 4 σχετίζεται με πτώση των εσόδων κατά περίπου €10,490 σε σύγκριση με το επίπεδο 1. Αυτός ο συντελεστής είναι στατιστικά σημαντικός σε επίπεδο 5%, κάτι που δείχνει ότι η επίδραση πιθανότατα δεν οφείλεται στην τύχη.
\(\gamma_4 = -4,320\): Στο επίπεδο τιμής 1, τα νέα προϊόντα αποφέρουν περίπου €4,320 λιγότερα έσοδα από τα υπάρχοντα προϊόντα. Ωστόσο, αυτή η επίδραση δεν διαφέρει στατιστικά σημαντικά από το 0 ούτε σε επίπεδο σημαντικότητας 10%, οπότε δεν μπορούμε να πούμε με βεβαιότητα ότι τα νέα και τα υπάρχοντα προϊόντα διαφέρουν ως προς τα έσοδα στο επίπεδο τιμής βάσης.
\(\gamma_5 = 14,726\): Για τα νέα προϊόντα στο επίπεδο τιμής 2, τα έσοδα αυξάνονται κατά περίπου €14,726 σε σχέση με αυτό που θα περιμέναμε αν απλώς προσθέταμε τις επιμέρους επιδράσεις του επιπέδου τιμής 2 και του ότι το προϊόν είναι νέο. Με άλλα λόγια, αυτή η αλληλεπίδραση «αντισταθμίζει» τις αρνητικές επιδράσεις του επιπέδου τιμής 2 και του ότι το προϊόν είναι νέο, φέρνοντας τη συνολική επίδραση πιο κοντά σε θετικό πρόσημο. Επίσης, αυτός ο όρος είναι στατιστικά σημαντικός σε επίπεδο σημαντικότητας 10%.
\(\gamma_6 = 17,585\): Παρόμοια αλληλεπίδραση εμφανίζεται στο επίπεδο τιμής 3. Για τα νέα προϊόντα αυτής της κατηγορίας τιμής, τα έσοδα προσαρμόζονται προς τα πάνω κατά περίπου €17,585 σε σύγκριση με αυτό που θα περιμέναμε μόνο από τις κύριες επιδράσεις. Αν και η επίδραση είναι μεγάλη σε μέγεθος, δεν διαφέρει στατιστικά σημαντικά από το 0 ούτε σε επίπεδο σημαντικότητας 10%.
\(\gamma_7 = 4,438\): Για τα νέα προϊόντα στο επίπεδο τιμής 4, η επίδραση αλληλεπίδρασης προσθέτει περίπου €4,438 στα έσοδα, αλλά και πάλι αυτή η προσαρμογή δεν διαφέρει στατιστικά σημαντικά από το 0 ούτε σε επίπεδο σημαντικότητας 10%.
Αυτά τα αποτελέσματα υποδηλώνουν ότι η επίδραση της εισαγωγής ενός νέου προϊόντος στα έσοδα εξαρτάται από το επίπεδο τιμής. Για παράδειγμα, ενώ τα νέα προϊόντα γενικά αποδίδουν χειρότερα από τα υπάρχοντα στο επίπεδο τιμής 1, αυτό το μοτίβο αλλάζει στα άλλα επίπεδα τιμής. Μάλιστα, η αρνητική επίδραση της εισαγωγής ενός νέου προϊόντος αντισταθμίζεται μερικώς ή πλήρως από τον όρο αλληλεπίδρασης στα επίπεδα τιμής 2 και 3. Αυτού του είδους η μοντελοποίηση αλληλεπιδράσεων είναι χρήσιμη όταν η επίδραση μιας μεταβλητής εξαρτάται από το επίπεδο μιας άλλης. Χωρίς τον όρο αλληλεπίδρασης, θα είχαμε υποθέσει ότι η επίδραση ενός νέου προϊόντος είναι ίδια σε όλα τα επίπεδα τιμής—κάτι που τα δεδομένα δεν φαίνεται να στηρίζουν.
2. Επίδραση αλληλεπίδρασης με συνεχή μεταβλητή και ψευδομεταβλητή:
Μια άλλη επιλογή είναι να συμπεριλάβουμε αλληλεπίδραση μεταξύ μιας ψευδομεταβλητής και μιας συνεχούς μεταβλητής. Σε αυτή την περίπτωση, η αλληλεπίδραση δεν μετατοπίζει απλώς τον σταθερό όρο—συνεπάγεται επίσης διαφορετική κλίση για τη συνεχή μεταβλητή ανάλογα με την τιμή της ψευδομεταβλητής.
Έτσι, τόσο ο σταθερός όρος όσο και η κλίση αλλάζουν για την ομάδα με κωδικό 1 (στο παράδειγμά μας, τα νέα προϊόντα). Αυτό μας επιτρέπει να μοντελοποιήσουμε διαφορετική σχέση μεταξύ διαφημιστικής δαπάνης και εσόδων για κάθε τύπο προϊόντος.
Για παράδειγμα, ας υποθέσουμε ότι θέλουμε να εξετάσουμε πώς το Ad_Spend και το New_Product επηρεάζουν από κοινού το Revenue. Είναι λογικό να σκεφτούμε ότι η επίδραση της διαφήμισης μπορεί να διαφέρει ανάλογα με το αν ένα προϊόν είναι νέο ή υπάρχον. Για να αποτυπώσουμε αυτή την πιθανότητα, συμπεριλαμβάνουμε στο μοντέλο έναν όρο αλληλεπίδρασης:
Αν ο όρος αλληλεπίδρασης είναι στατιστικά σημαντικός, αυτό θα έδειχνε ότι η σχέση μεταξύ Ad_Spend και Revenue εξαρτάται από το αν το προϊόν είναι νέο. Για παράδειγμα, η διαφήμιση μπορεί να προκαλεί μεγαλύτερη αύξηση των εσόδων στα νέα προϊόντα από ό,τι στα υπάρχοντα.
Στην R, συμπεριλαμβάνουμε αυτή την αλληλεπίδραση με τον ίδιο τρόπο, χρησιμοποιώντας τον αστερίσκο (*), ο οποίος προσθέτει και τις δύο κύριες επιδράσεις και την αλληλεπίδραση:
# Προσαρμογή μοντέλου γραμμικής παλινδρόμησης με επίδραση αλληλεπίδρασηςlm(Revenue ~ Ad_Spend * New_Product, data = eshop_revenues) %>%summary()
Call:
lm(formula = Revenue ~ Ad_Spend * New_Product, data = eshop_revenues)

Residuals:
   Min     1Q Median     3Q    Max
-35299  -6449  -2311   5227  49375

Coefficients:
                     Estimate Std. Error t value Pr(>|t|)
(Intercept)           5473.47    1753.46    3.12   0.0022 **
Ad_Spend                49.30       6.84    7.21  4.5e-11 ***
New_Product          -1254.88    3736.68   -0.34   0.7376
Ad_Spend:New_Product    38.59      14.32    2.70   0.0080 **
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 12000 on 126 degrees of freedom
Multiple R-squared:  0.458, Adjusted R-squared:  0.446
F-statistic: 35.6 on 3 and 126 DF,  p-value: <2e-16
Η ερμηνεία αυτού του αποτελέσματος είναι η εξής:
\(\beta_0 = 5,473.47\): Αυτά είναι τα αναμενόμενα έσοδα όταν Ad_Spend = 0 για τα υπάρχοντα προϊόντα (New_Product = 0). Ο συντελεστής είναι στατιστικά σημαντικός σε επίπεδο 1%, κάτι που δείχνει ότι αυτά τα βασικά έσοδα διαφέρουν αξιόπιστα από το μηδέν.
\(\beta_1 = 49.30\): Στα υπάρχοντα προϊόντα, μια αύξηση του Ad_Spend κατά 1 μονάδα σχετίζεται με αύξηση των εσόδων κατά περίπου €49.3, μια επίδραση στατιστικά σημαντική σε επίπεδο σημαντικότητας 1%.
\(\gamma_1 = -1,254.88\): Όταν Ad_Spend = 0, τα νέα προϊόντα έχουν χαμηλότερα έσοδα από τα υπάρχοντα κατά περίπου €1,255, αλλά αυτή η διαφορά δεν είναι στατιστικά σημαντική ούτε σε επίπεδο σημαντικότητας 10%.
\(\beta_2 = 38.59\): Στα νέα προϊόντα, η κλίση της διαφημιστικής δαπάνης αυξάνεται κατά €38.59 σε σύγκριση με τα υπάρχοντα προϊόντα. Αυτό σημαίνει ότι τα νέα προϊόντα ανταποκρίνονται περισσότερο στη διαφημιστική δαπάνη. Η συνολική κλίση για τα νέα προϊόντα είναι 49.30 + 38.59 = 87.89, και αυτή η επίδραση αλληλεπίδρασης είναι στατιστικά σημαντική σε επίπεδο 1%.
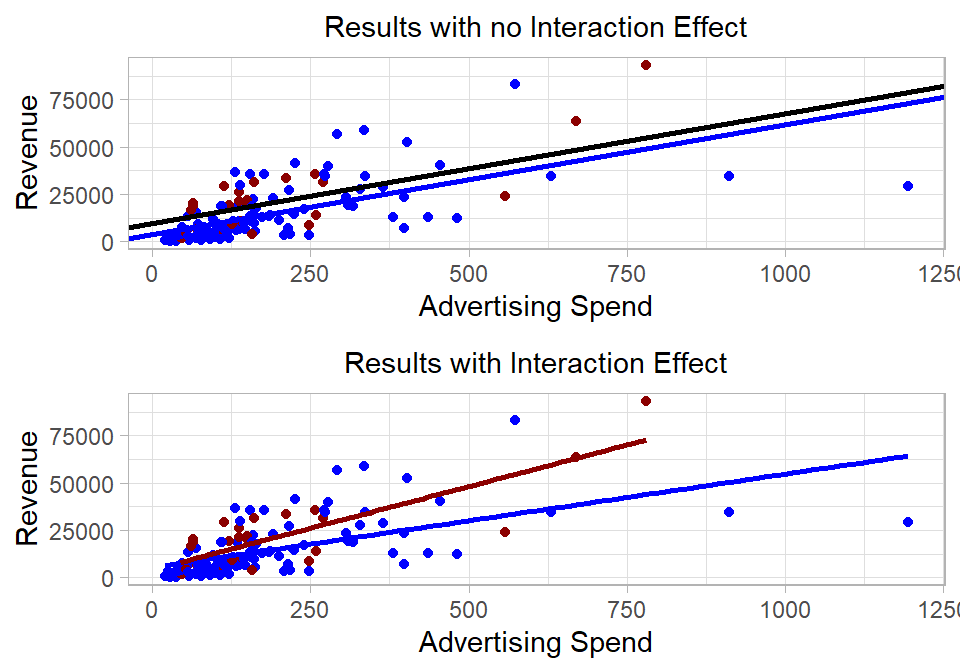
Για να δούμε οπτικά πώς διαφέρουν οι κλίσεις ανάλογα με τον τύπο του προϊόντος, μπορούμε να σχεδιάσουμε δύο ευθείες παλινδρόμησης, μία για τα νέα προϊόντα και μία για τα υπάρχοντα:
Εικόνα 26.5: Γραμμική παλινδρόμηση με και χωρίς όρους αλληλεπίδρασης.
Έτσι, η συμπερίληψη αλληλεπίδρασης μεταξύ μιας ψευδομεταβλητής και μιας συνεχούς μεταβλητής επιτρέπει στην παλινδρόμηση να εκτιμήσει διαφορετικές κλίσεις για κάθε ομάδα. Μάλιστα, οι εκτιμημένοι σταθεροί όροι και οι κλίσεις είναι ακριβώς ίδιοι με αυτούς που θα παίρναμε αν προσαρμόζαμε ξεχωριστό μοντέλο γραμμικής παλινδρόμησης για κάθε ομάδα. Ωστόσο, συμπεριλαμβάνοντας την αλληλεπίδραση σε ένα ενιαίο μοντέλο, κρατάμε τα πάντα ενοποιημένα, κάτι που διευκολύνει την άμεση σύγκριση των ομάδων και τον έλεγχο του αν οι διαφορές στις κλίσεις και στους σταθερούς όρους είναι στατιστικά σημαντικές.
Αυτή η ενοποιημένη προσέγγιση έχει αρκετά πλεονεκτήματα:
Μικρότερα standard errors: Όταν εκτιμούμε ξεχωριστά μοντέλα για κάθε ομάδα, κάθε μοντέλο χρησιμοποιεί μόνο ένα μέρος των δεδομένων, κάτι που μπορεί να οδηγήσει σε μεγαλύτερα standard errors, ιδιαίτερα αν οι ομάδες είναι μικρές. Συγκεντρώνοντας τα δεδομένα σε ένα ενιαίο μοντέλο με όρους αλληλεπίδρασης, αξιοποιούμε πιο αποτελεσματικά τα δεδομένα, κάτι που συχνά οδηγεί σε μικρότερα standard errors και πιο αξιόπιστες εκτιμήσεις (με την προϋπόθεση ότι το variance του σφάλματος είναι ίδιο και στις δύο ομάδες).
Καλύτερος έλεγχος σημαντικότητας: Ένα συνδυασμένο μοντέλο μάς επιτρέπει να ελέγξουμε κοινές υποθέσεις για τις ομάδες, όπως αν η κλίση διαφέρει πράγματι μεταξύ των ομάδων ή αν και οι δύο ομάδες έχουν τον ίδιο σταθερό όρο. Αυτό δεν θα ήταν τόσο απλό αν εκτιμούσαμε ξεχωριστά μοντέλα.
Αποτελεσματικότητα και φειδωλότητα του μοντέλου: Η συμπερίληψη όρων αλληλεπίδρασης σε ένα μοντέλο αποφεύγει την επανάληψη της ίδιας δουλειάς σε πολλά μοντέλα. Είναι υπολογιστικά και εννοιολογικά πιο «καθαρή» λύση, ιδιαίτερα όταν επεκτείνουμε το μοντέλο σε περισσότερες από δύο ομάδες ή προσθέτουμε επιπλέον προβλεπτικές μεταβλητές.
Καλύτερη ερμηνεία: Ένα ενιαίο μοντέλο κάνει πιο εύκολη την ερμηνεία του πώς συμπεριφέρεται μια συνεχής μεταβλητή σε διαφορετικές ομάδες, συγκρίνοντας απευθείας τις εκτιμημένες κλίσεις και τους σταθερούς όρους, μαζί με τα διαστήματα εμπιστοσύνης και τα p-values τους.
Συνοπτικά, ένα μοντέλο με όρους αλληλεπίδρασης αποτυπώνει επιδράσεις που διαφέρουν από ομάδα σε ομάδα αξιοποιώντας ολόκληρο το σύνολο δεδομένων, κάτι που οδηγεί σε πιο ακριβείς εκτιμήσεις και πιο κατατοπιστική στατιστική συμπερασματολογία.
3. Επίδραση αλληλεπίδρασης με συνεχείς μεταβλητές:
Η συμπερίληψη της επίδρασης αλληλεπίδρασης μεταξύ δύο συνεχών μεταβλητών είναι επίσης δυνατή και συχνά χρήσιμη όταν υποψιαζόμαστε ότι η σχέση μεταξύ μιας προβλεπτικής μεταβλητής και του αποτελέσματος εξαρτάται από το επίπεδο μιας άλλης προβλεπτικής μεταβλητής. Σε αυτή την περίπτωση, η αλληλεπίδραση δεν μετατοπίζει απλώς τον σταθερό όρο ούτε αλλάζει την κλίση με σταθερό τρόπο για μια ομάδα—δημιουργεί μια επίδραση που μεταβάλλεται συνεχώς και εξαρτάται από τις τιμές και των δύο μεταβλητών.
όπου τα \(x_1\) και \(x_2\) είναι δύο συνεχείς μεταβλητές. Οι συντελεστές \(\beta_1\) και \(\beta_2\) αποτυπώνουν τις κύριες επιδράσεις (main effects) αυτών των μεταβλητών, ενώ ο συντελεστής \(\beta_3\) αποτυπώνει την επίδραση αλληλεπίδρασης.
Ως παράδειγμα, ας υποθέσουμε ότι μας ενδιαφέρει πώς το Ad_Spend και το Website_Visitors επηρεάζουν μαζί το Revenue. Μπορεί να πιστεύουμε ότι η αποτελεσματικότητα της διαφημιστικής δαπάνης εξαρτάται από το πόσοι επισκέπτες έρχονται ήδη στον ιστότοπο (ή το αντίστροφο). Τότε, το μοντέλο μας γίνεται:
Αν ο όρος αλληλεπίδρασης είναι στατιστικά σημαντικός, αυτό υποδηλώνει ότι η σχέση μεταξύ Ad_Spend και Revenue εξαρτάται από τον αριθμό των Website_Visitors. Για παράδειγμα, η διαφήμιση μπορεί να είναι πιο αποτελεσματική όταν η επισκεψιμότητα του ιστότοπου είναι ήδη υψηλή, οπότε η συνδυασμένη επίδραση είναι μεγαλύτερη από το άθροισμα των επιμέρους επιδράσεων.
Για να εκτιμήσουμε αυτή την αλληλεπίδραση στην R, χρησιμοποιούμε και πάλι τον αστερίσκο (*) μέσα στη συνάρτηση lm():
# Προσαρμογή μοντέλου γραμμικής παλινδρόμησης με επίδραση αλληλεπίδρασηςlm(Revenue ~ Ad_Spend * Website_Visitors, data = eshop_revenues) %>%summary()
Call:
lm(formula = Revenue ~ Ad_Spend * Website_Visitors, data = eshop_revenues)

Residuals:
   Min     1Q Median     3Q    Max
-33824  -6069  -2360   6078  44907

Coefficients:
                           Estimate Std. Error t value Pr(>|t|)
(Intercept)               -1.59e+04   6.03e+03   -2.63  0.00953
Ad_Spend                   9.21e+01   2.68e+01    3.43  0.00081
Website_Visitors           1.88e+01   5.08e+00    3.69  0.00033
Ad_Spend:Website_Visitors -2.93e-02   1.73e-02   -1.70  0.09218

(Intercept)               **
Ad_Spend                  ***
Website_Visitors          ***
Ad_Spend:Website_Visitors .
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 12000 on 126 degrees of freedom
Multiple R-squared:  0.462, Adjusted R-squared:  0.449
F-statistic:   36 on 3 and 126 DF,  p-value: <2e-16
Η ερμηνεία αυτού του αποτελέσματος είναι η εξής:
\(\beta_0 = -15,881.38\): Αυτά είναι τα εκτιμημένα έσοδα όταν Ad_Spend = 0 και Website_Visitors = 0. Αν και αυτός ο συγκεκριμένος συνδυασμός μπορεί να μην είναι ρεαλιστικός στην πράξη, ο σταθερός όρος λειτουργεί ως σημείο αναφοράς. Είναι στατιστικά σημαντικός σε επίπεδο 1%.
\(\beta_1 = 92.15\): Αυτή είναι η επίδραση μιας αύξησης του Ad_Spend κατά 1 μονάδα στα έσοδα όταν Website_Visitors = 0, τιμή που βρίσκεται έξω από το εύρος των δεδομένων μας. Λόγω της αλληλεπίδρασης, η επίδραση του Ad_Spend εξαρτάται από τον αριθμό των επισκεπτών: είναι \(92.15 - 0.029 \times \text{WebsiteVisitors}\). Για παράδειγμα, στον μέσο αριθμό επισκεπτών (περίπου 1,151), μια αύξηση του Ad_Spend κατά 1 μονάδα σχετίζεται με μέση αύξηση των εσόδων κατά περίπου €58.40. Ο συντελεστής είναι στατιστικά σημαντικός σε επίπεδο 1%.
\(\beta_2 = 18.76\): Αντίστοιχα, αυτή είναι η επίδραση ενός επιπλέον επισκέπτη του ιστότοπου όταν Ad_Spend = 0. Στη μέση διαφημιστική δαπάνη (περίπου 189), ένας επιπλέον επισκέπτης σχετίζεται με μέση αύξηση των εσόδων κατά περίπου €13.22. Ο συντελεστής είναι επίσης στατιστικά σημαντικός σε επίπεδο 1%.
\(\beta_3 = -0.03\): Αυτή είναι η επίδραση αλληλεπίδρασης μεταξύ Ad_Spend και Website_Visitors. Δείχνει ότι η οριακή επίδραση του Ad_Spend μειώνεται ελαφρώς καθώς αυξάνεται ο αριθμός των επισκεπτών του ιστότοπου, και αντίστροφα. Συγκεκριμένα, για κάθε επιπλέον επισκέπτη, η επίδραση του Ad_Spend στα έσοδα μειώνεται κατά €0.029. Αυτή η επίδραση αλληλεπίδρασης είναι στατιστικά σημαντική σε επίπεδο σημαντικότητας 10%, κάτι που δίνει κάποιες ενδείξεις ότι η επίδραση μιας προβλεπτικής μεταβλητής μπορεί να εξαρτάται από το επίπεδο της άλλης.
Συνοψίζοντας, η συμπερίληψη αλληλεπίδρασης μεταξύ δύο συνεχών μεταβλητών επιτρέπει στο μοντέλο να αποτυπώσει περιπτώσεις όπου η επίδραση μιας μεταβλητής εξαρτάται από το επίπεδο μιας άλλης.
4. Άλλες επιδράσεις αλληλεπίδρασης:
Πέρα από τις περιπτώσεις που συζητήσαμε, τίποτα δεν μας εμποδίζει να χρησιμοποιήσουμε επιδράσεις αλληλεπίδρασης σε συνδυασμό με μετασχηματισμένες μεταβλητές, όπως λογαρίθμους ή τετραγωνικούς όρους, ή ακόμη και να δημιουργήσουμε όρους αλληλεπίδρασης με περισσότερες από δύο μεταβλητές. Αυτές οι επεκτάσεις μάς επιτρέπουν να αποτυπώσουμε πιο λεπτές σχέσεις στα δεδομένα, ιδιαίτερα όταν η επίδραση μιας μεταβλητής μπορεί να εξαρτάται τόσο από το επίπεδο όσο και από τον ρυθμό μεταβολής μιας άλλης.
Για παράδειγμα, μπορεί να συμπεριλάβουμε αλληλεπίδραση μεταξύ μιας ψευδομεταβλητής και μιας λογαριθμισμένης συνεχούς μεταβλητής, αν υποψιαζόμαστε φθίνουσες αποδόσεις για τη μία ομάδα αλλά όχι για την άλλη. Εναλλακτικά, η αλληλεπίδραση ενός τετραγωνικού όρου (π.χ. x^2) με μια άλλη μεταβλητή μπορεί να μας βοηθήσει να αποτυπώσουμε μη γραμμικές επιδράσεις που διαφέρουν από ομάδα σε ομάδα. Ομοίως, αλληλεπιδράσεις τριών μεταβλητών όπως η x1 * x2 * x3 μάς επιτρέπουν να εξετάσουμε πώς η κοινή επίδραση δύο μεταβλητών μεταβάλλεται ανάλογα με μια τρίτη—αν και η ερμηνεία γίνεται γρήγορα πιο σύνθετη.
Το βασικό αντιστάθμισμα είναι μεταξύ ερμηνευσιμότητας και ευελιξίας. Όσο προσθέτουμε περισσότερους όρους αλληλεπίδρασης, ιδιαίτερα μη γραμμικούς ή ανώτερης τάξης, το μοντέλο γίνεται πιο ευέλικτο και ικανό να προσαρμόζεται σε λεπτά μοτίβα των δεδομένων. Ωστόσο, αυτό αυξάνει και την πολυπλοκότητα, ιδιαίτερα σε μικρότερα σύνολα δεδομένων. Επιπλέον, η ερμηνεία επιδράσεων αλληλεπίδρασης με περισσότερες από δύο μεταβλητές απαιτεί συχνά οπτικά βοηθήματα ή διαγράμματα οριακών επιδράσεων (marginal effects plots), καθώς οι συντελεστές από μόνοι τους μπορεί να είναι δύσκολο να αναλυθούν. Έτσι, ενώ η εκφραστικότητα του μοντέλου αυξάνεται, αυξάνεται και η ανάγκη για προσοχή στην ερμηνεία και στην επικύρωση.
Στην πράξη, σπάνια χρησιμοποιούνται τόσο περίπλοκες επιδράσεις αλληλεπίδρασης, ιδιαίτερα όταν ο στόχος είναι η ερμηνεία. Όσο τα μοντέλα γίνονται πιο σύνθετα, οι συντελεστές γίνονται πιο δύσκολο να εξηγηθούν και ο κίνδυνος λανθασμένης ερμηνείας των σχέσεων αυξάνεται. Στην εφαρμοσμένη δουλειά—ιδιαίτερα στις επιχειρήσεις, στα οικονομικά και στις κοινωνικές επιστήμες—τα μοντέλα κρίνονται συχνά όχι μόνο από την προβλεπτική τους ακρίβεια, αλλά και από το πόσο καθαρά μεταδίδουν τα συμπεράσματά τους. Η προσθήκη πολλών ή μη γραμμικών όρων αλληλεπίδρασης μπορεί να συσκοτίσει αντί να διευκρινίσει την ιστορία που λένε τα δεδομένα.
Γιατί οι κύριες επιδράσεις πρέπει να συνοδεύουν τους όρους αλληλεπίδρασης
Ένα ενδιαφέρον ερώτημα είναι αν μπορούμε να συμπεριλάβουμε μόνο τους όρους αλληλεπίδρασης σε ένα μοντέλο γραμμικής παλινδρόμησης, χωρίς τις κύριες επιδράσεις. Αν και αυτό είναι τεχνικά δυνατό, γενικά δεν συνιστάται. Οι κύριες επιδράσεις αντιπροσωπεύουν την ατομική συμβολή κάθε προβλεπτικής μεταβλητής, ενώ οι όροι αλληλεπίδρασης αποτυπώνουν πώς συνδυάζονται οι προβλεπτικές μεταβλητές για να επηρεάσουν το αποτέλεσμα. Η παράλειψη των κύριων επιδράσεων μπορεί να κάνει το μοντέλο πιο δύσκολο στην ερμηνεία και να οδηγήσει σε παραπλανητικά συμπεράσματα, καθώς οι όροι αλληλεπίδρασης δεν αντανακλούν πλέον αποκλίσεις από τις προσθετικές επιδράσεις των επιμέρους μεταβλητών. Γι’ αυτό, είναι καλή πρακτική να συμπεριλαμβάνονται οι κύριες επιδράσεις κάθε φορά που προστίθενται όροι αλληλεπίδρασης.
Όλα μαζί
Πριν ολοκληρώσουμε αυτό το κεφάλαιο, ας τα συνδυάσουμε όλα προσαρμόζοντας ένα πιο ολοκληρωμένο μοντέλο γραμμικής παλινδρόμησης. Αυτό θα μας βοηθήσει να δούμε πώς λειτουργούν στην πράξη πολλές μεταβλητές και οι σχέσεις τους.
Θα εκτελέσουμε ένα μοντέλο γραμμικής παλινδρόμησης για το Revenue, με τις εξής προβλεπτικές μεταβλητές:
το log(Ad_Spend), για να λάβουμε υπόψη τις φθίνουσες αποδόσεις της διαφήμισης
το Website_Visitors και τον τετραγωνικό του όρο, για να επιτρέψουμε μια μη γραμμική σχέση
το Product_Quality_Score και το Customer_Satisfaction, μαζί με την αλληλεπίδρασή τους, για να αποτυπώσουμε χαρακτηριστικά του προϊόντος και της εξυπηρέτησης
το New_Product, για να λάβουμε υπόψη τις διαφορές μεταξύ νέων και υπαρχόντων προϊόντων
Θα ερμηνεύσουμε την τιμή κάθε συντελεστή, θα αξιολογήσουμε τη στατιστική του σημαντικότητα, θα σχολιάσουμε τη συνολική σημαντικότητα του μοντέλου και θα ελέγξουμε για ετεροσκεδαστικότητα. Τέλος, θα εκτελέσουμε έναν κοινό έλεγχο σημαντικότητας για τους συντελεστές του Product_Quality_Score, του Customer_Satisfaction και της επίδρασης αλληλεπίδρασής τους, για να δούμε αν από κοινού έχουν ουσιαστική επίδραση στο αποτέλεσμα.
Μπορούμε να προσαρμόσουμε αυτό το μοντέλο στην R με τον παρακάτω κώδικα:
# Προσαρμογή ενός τελικού μοντέλου γραμμικής παλινδρόμησηςlm_final_model <-lm(Revenue ~log(Ad_Spend) + Website_Visitors +I(Website_Visitors ^2) + Product_Quality_Score * Customer_Satisfaction + New_Product,data = eshop_revenues)# Εμφάνιση των αποτελεσμάτωνlm_final_model %>%summary()
\(\beta_0 = -21,163.75\): Αυτά είναι τα εκτιμημένα έσοδα όταν όλες οι προβλεπτικές μεταβλητές είναι μηδέν. Αν και αυτό το σενάριο μπορεί να μην είναι ρεαλιστικό, ο σταθερός όρος λειτουργεί ως το βασικό επίπεδο της επιφάνειας παλινδρόμησης. Δεν είναι στατιστικά σημαντικός ούτε σε επίπεδο 10%.
\(\beta_1 = 11,531.97\): Μια αύξηση του Ad_Spend κατά 1% σχετίζεται με αύξηση του Revenue κατά περίπου €115.32, κρατώντας τις άλλες μεταβλητές σταθερές. Αυτή η επίδραση είναι στατιστικά σημαντική σε επίπεδο σημαντικότητας 1%, δείχνοντας ισχυρή και θετική σχέση μεταξύ διαφήμισης και εσόδων.
\(\beta_2 = -42.34\): Κάθε επιπλέον επισκέπτης του ιστότοπου σχετίζεται με μείωση των εσόδων κατά €42.34, κρατώντας τις άλλες μεταβλητές σταθερές. Αυτό μπορεί να φαίνεται αντιφατικό, αλλά πρέπει να το ερμηνεύσουμε μαζί με τον τετραγωνικό όρο παρακάτω, καθώς η σχέση είναι μη γραμμική. Ο συντελεστής είναι στατιστικά σημαντικός σε επίπεδο 5%.
\(\beta_3 = 0.02\): Αυτός είναι ο συντελεστής του τετραγωνικού όρου του Website_Visitors. Είναι θετικός και στατιστικά σημαντικός σε επίπεδο σημαντικότητας 5%, κάτι που υποδηλώνει ότι η επίδραση των επισκεπτών στα έσοδα γίνεται πιο θετική (ή λιγότερο αρνητική) καθώς αυξάνεται ο αριθμός των επισκεπτών. Αυτό συνεπάγεται μια σχέση σε σχήμα U: τα έσοδα αρχικά μειώνονται με περισσότερους επισκέπτες, αλλά στη συνέχεια αρχίζουν να αυξάνονται σε υψηλότερα επίπεδα. Το εκτιμημένο σημείο καμπής είναι περίπου στους \(42.34 / (2 \times 0.0207) \approx 1022\) επισκέπτες, τιμή που βρίσκεται μέσα στο εύρος των δεδομένων μας.
\(\beta_4 = -5,134.25\): Μια αύξηση του Product_Quality_Score κατά μία μονάδα σχετίζεται με μείωση των εσόδων όταν η ικανοποίηση πελατών είναι σταθερή στο μηδέν. Ωστόσο, αυτός ο συντελεστής δεν είναι στατιστικά σημαντικός ούτε σε επίπεδο σημαντικότητας 10% και πρέπει επίσης να ερμηνεύεται μαζί με την αλληλεπίδρασή του με την ικανοποίηση πελατών.
\(\beta_5 = -2,497.92\): Μια αύξηση του Customer_Satisfaction κατά μία μονάδα σχετίζεται με μείωση των εσόδων όταν η βαθμολογία ποιότητας του προϊόντος είναι μηδέν. Και πάλι, ο συντελεστής δεν είναι στατιστικά σημαντικός ούτε σε επίπεδο σημαντικότητας 10%, και η μεμονωμένη ερμηνεία του είναι περιορισμένη λόγω του όρου αλληλεπίδρασης.
\(\gamma_1 = 4,545.25\): Τα νέα προϊόντα σχετίζονται με μέση αύξηση των εσόδων κατά περίπου €4,545 σε σύγκριση με τα υπάρχοντα προϊόντα, κρατώντας τους άλλους παράγοντες σταθερούς. Αυτή η επίδραση είναι στατιστικά σημαντική σε επίπεδο 5%.
\(\beta_6 = 1,029.18\): Αυτή είναι η αλληλεπίδραση μεταξύ Product_Quality_Score και Customer_Satisfaction. Δείχνει πώς η συνδυασμένη επίδραση αυτών των δύο μεταβλητών επηρεάζει τα έσοδα. Αν και αυτός ο όρος αλληλεπίδρασης δεν είναι στατιστικά σημαντικός ούτε σε επίπεδο 10%, το πρόσημο και το μέγεθός του υποδηλώνουν ότι, όταν η ποιότητα και η ικανοποίηση αυξάνονται μαζί, η κοινή τους επίδραση μπορεί να είναι θετική.
Όσον αφορά την προσαρμογή του μοντέλου, το R-squared και το adjusted R-squared είναι και τα δύο μεταξύ 60% και 65%, κάτι που υποδηλώνει ισχυρή προσαρμογή του μοντέλου. Το p-value της συνολικής σημαντικότητας είναι μικρότερο από 0.01, κάτι που υποδηλώνει ότι το μοντέλο στο σύνολό του εξηγεί ένα σημαντικό μέρος της μεταβλητότητας των εσόδων και ότι τουλάχιστον μία από τις προβλεπτικές μεταβλητές σχετίζεται ουσιαστικά με το αποτέλεσμα.
Αυτό το μοντέλο δίνει ισχυρές ενδείξεις για τη θετική επίδραση της διαφήμισης και κάποιες ενδείξεις ότι τα νέα προϊόντα αποδίδουν καλύτερα. Αν και οι μεμονωμένες επιδράσεις της ποιότητας και της ικανοποίησης δεν είναι σημαντικές από μόνες τους, η συνδυασμένη αλληλεπίδρασή τους μπορεί να έχει πρακτική σημασία και αξίζει περαιτέρω διερεύνηση.
Για να εκτιμήσουμε με αυστηρό τρόπο αν υπάρχει ετεροσκεδαστικότητα στο μοντέλο παλινδρόμησής μας, θα χρησιμοποιήσουμε την εκδοχή F του ελέγχου Breusch-Pagan. Αυτός ο έλεγχος εξετάζει αν το variance των καταλοίπων εξαρτάται συστηματικά από μία ή περισσότερες ερμηνευτικές μεταβλητές, κάτι που θα παραβίαζε την υπόθεση του σταθερού variance (ομοσκεδαστικότητα) που απαιτείται για την τυπική συμπερασματολογία (βλ. Κεφάλαιο Γραμμική παλινδρόμηση - Στατιστική συμπερασματολογία).
Δείτε πώς υλοποιούμε τον έλεγχο στην R:
# Εξαγωγή των καταλοίπων και ύψωσή τους στο τετράγωνοu <- lm_final_model %>%residuals()u_squared <- u^2# Βοηθητική παλινδρόμηση: τετραγωνισμένα κατάλοιπα στις αρχικές προβλεπτικές μεταβλητέςlm(u_squared ~log(Ad_Spend) + Website_Visitors +I(Website_Visitors^2) + Product_Quality_Score * Customer_Satisfaction + New_Product,data = eshop_revenues) %>%summary()
Το p-value του στατιστικού F αυτής της βοηθητικής παλινδρόμησης είναι μικρότερο από 0.01, κάτι που αποτελεί ισχυρή ένδειξη ετεροσκεδαστικότητας, δηλαδή ότι το variance των καταλοίπων μεταβάλλεται με τις προβλεπτικές μεταβλητές.
Για να κάνουμε πιο έγκυρη στατιστική συμπερασματολογία παρά την ετεροσκεδαστικότητα, πρέπει να χρησιμοποιήσουμε ανθεκτικά standard errors στην ετεροσκεδαστικότητα. Έτσι μπορούμε να εμπιστευτούμε τους ελέγχους υποθέσεων και τα διαστήματα εμπιστοσύνης μας χωρίς την υπόθεση της ομοσκεδαστικότητας.
Ακολουθεί ο κώδικας R για τον υπολογισμό ανθεκτικών standard errors και τον έλεγχο των συντελεστών:
# Βιβλιοθήκεςlibrary(sandwich)library(lmtest)# Υπολογισμός των ανθεκτικών standard errorsrobust_se <-vcovHC(lm_final_model, type ="HC1")# Εκτέλεση ελέγχων των συντελεστών με ανθεκτικά standard errorscoeftest(lm_final_model, vcov = robust_se)
Μετά την εφαρμογή των ανθεκτικών standard errors, παρατηρούμε ότι τα p-values τόσο της κύριας επίδρασης όσο και του τετραγωνικού όρου του Website_Visitors έχουν αυξηθεί και δεν είναι πλέον στατιστικά σημαντικά. Αυτό υποδηλώνει ότι η αρχική σημαντικότητα που παρατηρήσαμε μπορεί να είχε επηρεαστεί από την ετεροσκεδαστικότητα, και ότι τα ανθεκτικά standard errors δίνουν σε αυτή την περίπτωση πιο αξιόπιστη συμπερασματολογία.
Τώρα μπορούμε να εκτελέσουμε έναν κοινό έλεγχο σημαντικότητας για τους συντελεστές του Product_Quality_Score, του Customer_Satisfaction και της επίδρασης αλληλεπίδρασής τους. Ωστόσο, επειδή εντοπίσαμε ετεροσκεδαστικότητα, δεν μπορούμε να βασιστούμε στο συνηθισμένο F-test. Θυμηθείτε από το Κεφάλαιο Γραμμική παλινδρόμηση - Στατιστική συμπερασματολογία ότι η έγκυρη στατιστική συμπερασματολογία στο Κλασικό Γραμμικό Μοντέλο (CLM) βασίζεται στην υπόθεση της ομοσκεδαστικότητας. Όταν αυτή η υπόθεση παραβιάζεται, τα συνηθισμένα standard errors δεν είναι πλέον σωστά, και αυτό επηρεάζει όχι μόνο τα μεμονωμένα t-tests αλλά και τους κοινούς ελέγχους σημαντικότητας. Αν και οι εκτιμημένοι συντελεστές παραμένουν ίδιοι, η μεταβλητότητα που χρησιμοποιείται για την αξιολόγηση της στατιστικής τους σημαντικότητας δεν μετριέται πλέον σωστά. Για να αντιμετωπίσουμε αυτό το πρόβλημα, χρησιμοποιούμε ένα ανθεκτικό F-test στην ετεροσκεδαστικότητα (heteroskedasticity-robust F-test), το οποίο συχνά αναφέρεται ως ανθεκτικός έλεγχος Wald (robust Wald test) (Wooldridge, 2020). Αυτός ο έλεγχος προσαρμόζει τον πίνακα covariance των εκτιμημένων συντελεστών, αφήνοντας αμετάβλητους τους ίδιους τους συντελεστές, και μας επιτρέπει να εκτελούμε έγκυρους κοινούς ελέγχους υποθέσεων ακόμη και όταν παραβιάζεται η υπόθεση του σταθερού variance των σφαλμάτων.
Στην R, μπορούμε και πάλι να χρησιμοποιήσουμε τη συνάρτηση linearHypothesis() για τον έλεγχο της από κοινού σημαντικότητας. Για να εκτελέσουμε ένα F-test ανθεκτικό στην ετεροσκεδαστικότητα, δίνουμε στο όρισμα vcov τον ανθεκτικό στην ετεροσκεδαστικότητα πίνακα covariance που υπολογίσαμε νωρίτερα. Συγκεκριμένα, περνάμε το object robust_se σε αυτό το όρισμα:
Το p-value αυτού του F-test είναι πολύ μικρότερο από 0.01, κάτι που σημαίνει ότι αυτές οι μεταβλητές συμβάλλουν από κοινού σημαντικά στην εξήγηση της μεταβλητότητας του Revenue. Αυτό έρχεται σε αντίθεση με τους ελέγχους των μεμονωμένων συντελεστών και τονίζει τη σημασία του ελέγχου κοινών υποθέσεων όταν οι μεταβλητές σχετίζονται ή αλληλεπιδρούν.
Ανακεφαλαίωση
Σε αυτό το κεφάλαιο, συζητήσαμε ορισμένα προχωρημένα θέματα της γραμμικής παλινδρόμησης, εστιάζοντας στο πώς επεκτείνουμε το βασικό μοντέλο για να αποτυπώνει καλύτερα σύνθετες σχέσεις στα δεδομένα. Παρουσιάσαμε μη γραμμικά στοιχεία, όπως τους λογαριθμικούς μετασχηματισμούς και τους τετραγωνικούς όρους, και εξετάσαμε πώς αυτά αλλάζουν την ερμηνεία των συντελεστών. Εξετάσαμε επίσης επιδράσεις αλληλεπίδρασης, τόσο μεταξύ συνεχών μεταβλητών όσο και μεταξύ συνεχών και κατηγορικών μεταβλητών, ώστε να επιτρέψουμε σχέσεις που διαφέρουν από ομάδα σε ομάδα.
Σε όλο το κεφάλαιο, τονίσαμε τη σημασία της προσεκτικής ερμηνείας καθώς τα μοντέλα γίνονται πιο σύνθετα. Τέλος, κατασκευάσαμε ένα ολοκληρωμένο μοντέλο γραμμικής παλινδρόμησης που ενσωμάτωσε αρκετές από αυτές τις επεκτάσεις, ερμηνεύσαμε τους συντελεστές του, ελέγξαμε για ετεροσκεδαστικότητα και εφαρμόσαμε ανθεκτικά standard errors στην ετεροσκεδαστικότητα για να υποστηρίξουμε έγκυρη στατιστική συμπερασματολογία. Αυτό το τελικό παράδειγμα έδειξε πώς όλες οι επιμέρους τεχνικές μπορούν να συνδυαστούν στην πράξη για να δημιουργηθεί ένα πιο πλούσιο και πιο αξιόπιστο μοντέλο.